WRITING
第三章 进程管理(计算)子系统
第三章 进程管理(计算)子系统
3.1 操作系统原理:进程与线程的本质
3.1.1 什么是进程
**进程(Process)**是操作系统进行资源分配和调度的基本单位,是程序的一次执行过程。一个进程包含:
程序代码:要执行的指令(代码段,通常只读且可共享)。
数据:程序运行时的数据(数据段、BSS 段、堆、栈)。
资源:打开的文件、网络连接、信号处理器、地址空间等。
执行上下文:程序计数器、寄存器、栈指针等 CPU 状态。
进程的核心特征是隔离性:每个进程有独立的地址空间,一个进程的崩溃不会直接影响其他进程(除非通过 IPC 交互)。
3.1.2 什么是线程
**线程(Thread)**是进程内的执行单元,是 CPU 调度的最小单位。同一进程内的多个线程:
共享:地址空间、文件描述符、信号处理器、全局变量等进程资源。
私有:各自的栈、寄存器上下文、程序计数器、线程局部存储(TLS)。
线程的引入是为了在保持资源共享的同时实现并发执行。相比多进程,多线程的上下文切换开销更小(不需要切换地址空间),线程间通信也更简单(直接共享内存),但需要更小心地处理同步问题(竞态条件、死锁)。
3.1.3 Linux 的设计:进程与线程的统一
Linux 内核并不严格区分进程和线程。在内核中,两者都用 task_struct 描述,都通过 clone() 系统调用创建,区别仅在于 clone() 的参数指定了哪些资源共享、哪些资源独立:
clone 标志 | 含义 | 进程(fork) | 线程(pthread_create) |
|---|---|---|---|
| 共享地址空间 | 否(复制) | 是 |
| 共享文件系统信息 | 否 | 是 |
| 共享文件描述符表 | 否 | 是 |
| 共享信号处理器 | 否 | 是 |
| 加入同一线程组 | 否 | 是 |
| 设置 TLS | 否 | 是 |
| 共享父进程 | 否 | 可选 |
这种统一设计的好处是:内核不需要为进程和线程维护两套独立的逻辑,调度器、内存管理等子系统对两者一视同仁,简化了内核设计。
3.1.4 进程的状态
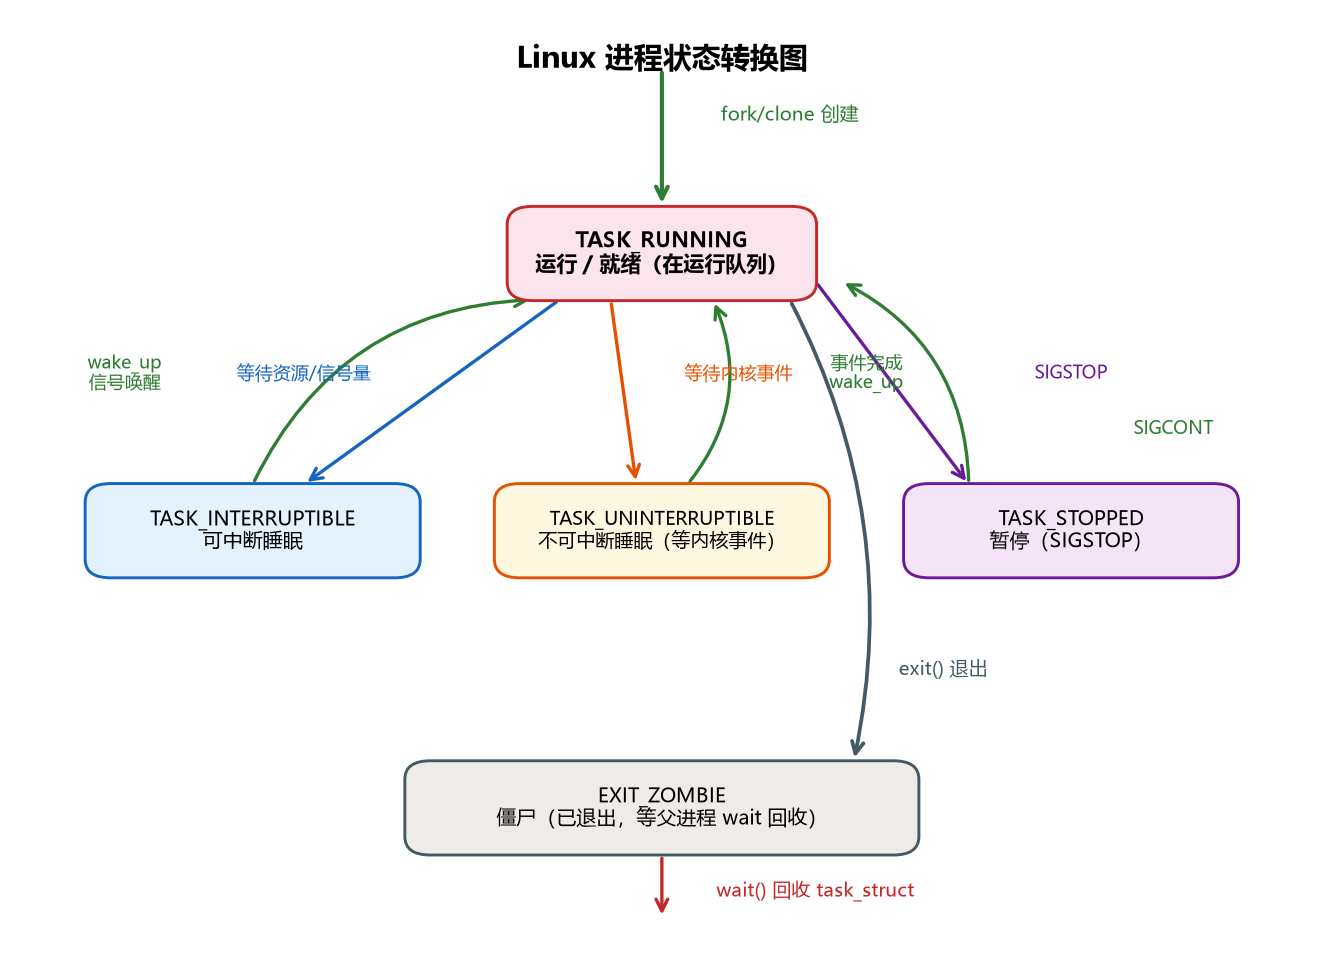
一个进程在其生命周期中会在不同状态之间转换:
                     fork()
                       │
                       ▼
                 ┌──────────┐
            ┌───▶│  RUNNING │◀───┐
            │    │ (运行/就绪) │    │
            │    └──────────┘    │
            │       │  ▲          │
   等待资源/IO │       │  │ 时间片用完 │ 被唤醒
            │       ▼  │          │
            │    ┌──────────┐    │
            │    │ SLEEPING │    │
            │    │(可中断/   │    │
            │    │ 不可中断) │    │
            │    └──────────┘    │
            │       │             │
   收到信号/  │       │ 等待的事件发生
   IO 完成    │       ▼             │
            │    ┌──────────┐    │
            │    │  STOPPED │    │
            │    │ (暂停)    │    │
            │    └──────────┘    │
            │       │             │
            │       │ SIGCONT     │
            │       ▼             │
            │    ┌──────────┐    │
            └────│ ZOMBIE   │────┘
                 │ (僵尸)    │
                 └──────────┘
                       │
                       │ wait()/waitpid()
                       ▼
                    终止
TASK_RUNNING:进程正在运行,或在运行队列中等待调度。这是唯一可以在 CPU 上执行的状态。
TASK_INTERRUPTIBLE:可中断睡眠,进程等待某事件(如 IO 完成、信号),可以被信号唤醒。
TASK_UNINTERRUPTIBLE:不可中断睡眠,常用于必须等待内核事件完成的短临界等待。普通信号不会使这种等待提前返回,任务通常由对应事件的唤醒路径恢复;这不等于“永远杀不掉”,而是信号要等任务离开该状态后才能生效。
TASK_STOPPED:进程被暂停(收到 SIGSTOP/SIGTSTP 等信号),等待 SIGCONT 恢复。
EXIT_ZOMBIE:僵尸退出状态,进程已退出但父进程尚未调用
wait()回收其退出状态。此时仍保留内核任务记录和退出信息,等待父进程回收。
3.2 核心数据结构:task_struct 详解
源码位置:include/linux/sched.h
task_struct 是 Linux 内核中最核心、最庞大的数据结构之一,描述了一个进程/线程的全部信息。它有数百个字段,以下按功能分类详解关键字段。
3.2.1 状态与标识
struct task_struct {
#ifdef CONFIG_THREAD_INFO_IN_TASK
    struct thread_info thread_info;  /* 线程信息(必须是第一个字段) */
#endif
    unsigned int __state;             /* 进程状态(TASK_RUNNING 等) */
    void *stack;                      /* 内核栈指针 */
    refcount_t usage;                 /* 引用计数 */
    unsigned int flags;               /* 进程标志(PF_*) */
    unsigned int ptrace;              /* ptrace 标志 */

    int on_rq;                        /* 是否在运行队列上(0/1/2) */
    int prio;                         /* 动态优先级 */
    int static_prio;                  /* 静态优先级(nice 值决定) */
    int normal_prio;                  /* 正常优先级 */
    unsigned int rt_priority;         /* 实时优先级 */
    unsigned int policy;              /* 调度策略(SCHED_NORMAL 等) */
    const struct sched_class *sched_class;  /* 调度类 */
    struct sched_entity se;           /* CFS 调度实体 */
    struct sched_rt_entity rt;        /* 实时调度实体 */
    struct sched_dl_entity dl;        /* 截止时间调度实体 */
    /* ... */
};
thread_info 的作用:在 CONFIG_THREAD_INFO_IN_TASK 开启时(现代内核默认开启),thread_info 嵌入在 task_struct 的开头。它包含架构相关的线程信息,如标志、当前 CPU 编号等。x86-64 上获取当前进程的 current 宏并不通过栈指针计算,而是直接读取 per-CPU 变量 current_task(详见 3.3.4)。
flags 常见标志:
PF_KTHREAD:内核线程PF_EXITING:正在退出PF_EXITPIDONE:退出完成PF_VCPU:虚拟 CPU 线程PF_IO_WORKER:IO 工作线程PF_MEMALLOC:允许使用预留内存(回收上下文)PF_FORKNOEXEC:fork 后尚未 execPF_SUPERPRIV:使用了超级用户权限
优先级体系:
static_prio:静态优先级,由 nice 值(-20~19)决定,启动时设定,可通过nice()/setpriority()修改。公式:static_prio = 120 + nice。normal_prio:正常优先级,基于静态优先级和调度策略计算。普通进程等于 static_prio,实时进程基于 rt_priority。prio:动态优先级,调度器实际使用的优先级。可能被临时调整(如优先级继承、PI 互斥量)。rt_priority:实时优先级,1~99(数值越大优先级越高),仅对实时调度策略有效。
3.2.2 进程关系与标识
struct task_struct {
    pid_t pid;                         /* 线程 ID,每个 task_struct 唯一(gettid 返回它) */
    pid_t tgid;                        /* 线程组 ID,即用户态看到的进程 ID(getpid 返回它) */
    struct task_struct __rcu *parent; /* 父进程 */
    struct list_head children;         /* 子进程链表 */
    struct list_head sibling;          /* 兄弟进程链表 */
    struct task_struct *group_leader;  /* 线程组组长 */
    struct list_head thread_group;      /* 线程组链表 */
    struct pid *thread_pid;             /* 线程 PID(内核内部表示) */
    struct pid *pids[PIDTYPE_MAX];      /* 各种 PID 类型 */
    char comm[TASK_COMM_LEN];            /* 进程名(16 字节) */
    /* ... */
};
PID 与 TGID 的区别:
在内核中,每个
task_struct(包括线程)都有一个唯一的pid(由thread_pid表示)。tgid(thread group ID)是线程组的 ID,也就是用户态看到的"进程 ID"。同一进程的所有线程共享同一个 tgid。对于进程的主线程,
pid == tgid;对于其他线程,pid != tgid。用户态的
getpid()返回的是tgid,gettid()返回的是pid。
进程关系:
parent:指向创建当前进程的父进程。children:当前进程的所有子进程的链表头。sibling:将当前进程链接到父进程的 children 链表中。group_leader:线程组的组长(通常是主线程)。thread_group:将当前线程链接到线程组链表中。
3.2.3 内存管理相关
struct task_struct {
    struct mm_struct *mm;          /* 进程地址空间(内核线程为 NULL) */
    struct mm_struct *active_mm;   /* 活跃地址空间(内核线程借用) */
    /* 页表页数统计在 mm_struct->pgtables_bytes,不在 task_struct 中 */
    /* ... */
};
mm 与 active_mm 的区别:
mm:指向进程自己的地址空间。用户进程有独立的mm_struct;内核线程的mm为 NULL,因为内核线程不需要用户地址空间。active_mm:指向当前正在使用的地址空间。对于用户进程,active_mm == mm。对于内核线程,active_mm指向前一个用户进程的mm(借用其页表,因为内核空间页表全局共享,内核线程只访问内核空间)。上下文切换时,如果切换到内核线程,不需要切换页表(
switch_mm跳过),直接借用前一个进程的active_mm。这是一个重要的优化。
3.2.4 文件系统与文件描述符
struct task_struct {
    struct files_struct *files;     /* 文件描述符表 */
    struct fs_struct *fs;           /* 文件系统信息(根目录、当前目录) */
    struct nsproxy *nsproxy;        /* 命名空间代理(mnt/pid/net/uts/ipc/cgroup) */
    /* ... */
};
files:包含文件描述符数组(fd_array),每个 fd 指向一个struct file。进程通过 fd 引用打开的文件。fs:包含根目录(root)、当前工作目录(pwd)、umask 等。chdir()修改pwd,chroot()修改root。nsproxy:指向命名空间代理,包含各种命名空间(mount、pid、network、UTS、IPC、cgroup)。命名空间是容器技术的基础。
3.2.5 信号处理
struct task_struct {
    struct signal_struct *signal;    /* 信号处理器(进程级,线程共享) */
    struct sighand_struct *sighand;  /* 信号处理函数表(线程共享) */
    sigset_t blocked;                 /* 阻塞信号集 */
    sigset_t real_blocked;            /* 实际阻塞信号集 */
    struct sigpending pending;         /* 挂起信号(线程私有) */
    unsigned long sas_ss_sp;           /* 备用信号栈地址 */
    size_t sas_ss_size;                /* 备用信号栈大小 */
    /* ... */
};
signal:进程级信号信息,包括共享的挂起信号队列、资源限制、会话信息等。同一线程组共享。sighand:信号处理函数表(action[]),定义每个信号的处理方式(默认/忽略/自定义处理函数)。同一线程组共享。blocked:线程私有的阻塞信号集,sigprocmask()修改。pending:线程私有的挂起信号队列。发送给特定线程的信号放在这里;发送给进程的信号放在signal->shared_pending,可以被线程组中任意线程处理。
3.2.6 调度与统计
struct task_struct {
    const cpumask_t *cpus_ptr;        /* 实际生效的 CPU 亲和性掩码 */
    cpumask_t *user_cpus_ptr;         /* 用户经 sched_setaffinity 设置的掩码 */
    /* 当前所在 CPU 不保存在 task_struct,而在 thread_info 中,用 task_cpu(p) 读取 */

    struct sched_entity se;           /* CFS 调度实体,exec_start、vruntime 都在其中 */

    struct task_cputime cputime;       /* CPU 时间统计 */
    u64 utime;                          /* 用户态 CPU 时间 */
    u64 stime;                          /* 内核态 CPU 时间 */
    unsigned long nvcsw;                /* 自愿上下文切换次数 */
    unsigned long nivcsw;               /* 非自愿上下文切换次数 */
    /* ... */
};
3.2.7 架构相关:thread_struct
struct task_struct {
    /* ... */
    struct thread_struct thread;  /* 架构相关的线程状态(x86 下在 task_struct 末尾) */
};
thread_struct 是架构相关的,x86 下包含:
寄存器上下文(切换时保存/恢复)
段寄存器(fs/gs,用于 TLS)
扩展寄存器状态(FPU/XMM/YMM/ZMM 等,由 xstate/FPU 代码管理)
调试寄存器
IO 权限位图
3.3 进程创建:fork / clone / kernel_clone
3.3.1 系统调用入口
Linux 提供多个创建进程/线程的系统调用,最终都汇聚到 kernel_clone():
系统调用 | 用途 | 典型 clone flags |
|---|---|---|
| 创建子进程,复制全部资源 |
|
| 创建子进程,父进程阻塞直到子进程 exec/exit |
|
| 精细控制共享哪些资源 | 由用户指定 |
| clone 的扩展版本,支持更多参数 | 由用户指定 |
| 创建内核线程 |
|
源码位置:kernel/fork.c
SYSCALL_DEFINE0(fork)
{
    struct kernel_clone_args args = {
        .exit_signal = SIGCHLD,
    };
    return kernel_clone(&args);
}

SYSCALL_DEFINE1(clone, unsigned long, clone_flags)
{
    /* 从用户栈读取参数,构造 kernel_clone_args */
    return kernel_clone(&args);
}
3.3.2 kernel_clone() 主流程
pid_t kernel_clone(struct kernel_clone_args *args)
{
    /* 1. 参数检查与准备 */
    if (args->flags & CLONE_PIDFD)
        /* 分配 pidfd */

    /* 2. 核心:创建新进程的 task_struct 并复制资源 */
    p = copy_process(NULL, trace, NUMA_NO_NODE, args);

    /* 3. 唤醒新进程,加入调度队列 */
    wake_up_new_task(p);

    /* 4. 返回子进程 PID(父进程返回值) */
    return pid;
}
kernel_clone() 的逻辑很简洁:调用 copy_process() 创建进程,然后 wake_up_new_task() 唤醒它。核心工作都在 copy_process() 中。
3.3.3 copy_process() 详解
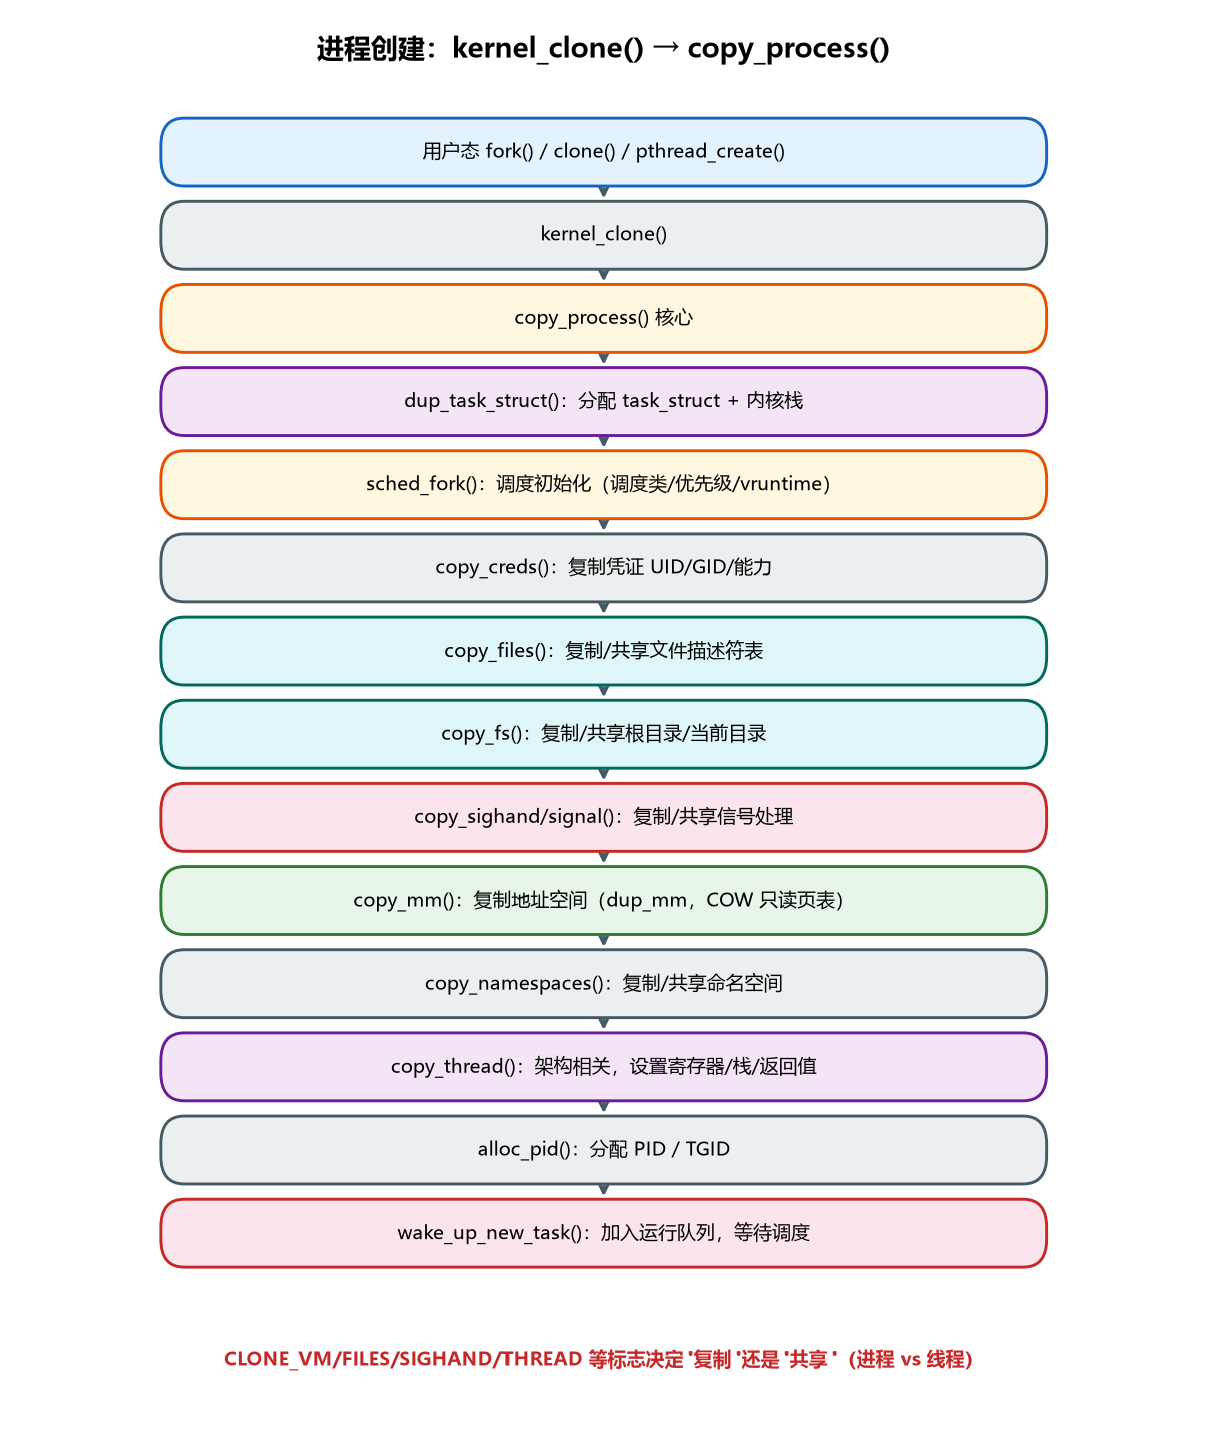
copy_process() 是进程创建的核心,完成以下工作:
copy_process()
  │
  ├─ 1. 权限与限制检查
  │     - 检查 RLIMIT_NPROC(用户进程数限制)
  │     - 检查用户命名空间权限
  │     - 检查 clone flags 合法性
  │
  ├─ 2. 复制 task_struct 和内核栈
  │     → dup_task_struct()
  │       - 从 task_struct kmem_cache 分配新 task_struct
  │       - 分配内核栈(thread_stack)
  │       - 复制父进程的 task_struct 内容
  │       - 初始化引用计数、统计信息
  │
  ├─ 3. 初始化调度相关
  │     → sched_fork()
  │       - 设置新进程的调度类和优先级
  │       - 初始化调度实体(se/rt/dl)
  │       - 设置新进程状态为 TASK_NEW
  │
  ├─ 4. 逐项复制进程资源
  │     ├─ copy_creds()       复制凭证(UID/GID/能力)
  │     ├─ copy_semundo()     复制 sem_undo 列表
  │     ├─ copy_files()       复制/共享文件描述符表
  │     ├─ copy_fs()          复制/共享文件系统信息
  │     ├─ copy_sighand()     复制/共享信号处理函数表
  │     ├─ copy_signal()      复制/共享信号结构体
  │     ├─ copy_mm()          复制/共享地址空间
  │     ├─ copy_namespaces()  复制/共享命名空间
  │     ├─ copy_io()          复制 IO 上下文
  │     ├─ copy_thread()      复制寄存器上下文和栈(架构相关)
  │     └─ cgroup_fork()     继承并初始化 cgroup 关联;随后由 cgroup_can_fork()/cgroup_post_fork() 校验和收尾
  │
  ├─ 5. 分配 PID
  │     → alloc_pid()
  │       - 从 PID 分配器分配唯一 PID
  │       - 设置 tgid(如果是线程组组长,tgid=pid)
  │
  ├─ 6. 完成初始化
  │     - 设置进程名(comm)
  │     - 初始化锁、等待队列
  │     - 加入进程链表和哈希表
  │     - 设置进程状态为 TASK_RUNNING(但尚未加入运行队列)
  │
  └─ 7. 返回新进程的 task_struct
源码位置:kernel/fork.c
static __latent_entropy struct task_struct *copy_process(
    struct pid *pid, int trace, int node,
    struct kernel_clone_args *args)
{
    /* ... 权限检查 ... */

    /* 2. 复制 task_struct 和内核栈 */
    p = dup_task_struct(current, node);
    if (!p) goto fork_out;

    /* 3. 调度初始化 */
    retval = sched_fork(clone_flags, p);
    if (retval) goto bad_fork_cleanup;

    /* 4. 逐项复制资源 */
    retval = copy_creds(p, clone_flags);
    /* ... */
    retval = copy_files(clone_flags, p);
    /* ... */
    retval = copy_fs(clone_flags, p);
    /* ... */
    retval = copy_sighand(clone_flags, p);
    /* ... */
    retval = copy_signal(clone_flags, p);
    /* ... */
    retval = copy_mm(clone_flags, p);
    /* ... */
    retval = copy_namespaces(clone_flags, p);
    /* ... */
    retval = copy_thread(clone_flags, args->stack, args->stack_size, p, args->tls);
    /* ... */

    /* 5. 分配 PID */
    if (pid != &init_struct_pid) {
        pid = alloc_pid(p->nsproxy->pid_ns_for_children);
        /* ... */
    }
    p->pid = pid_nr(pid);
    if (clone_flags & CLONE_THREAD) {
        p->exit_signal = -1;
        p->group_leader = current->group_leader;
        p->tgid = current->tgid;
    } else {
        p->exit_signal = args->exit_signal;
        p->group_leader = p;
        p->tgid = p->pid;
    }

    /* 6. 完成初始化 */
    /* ... */

    return p;
}
3.3.4 dup_task_struct() 详解
static struct task_struct *dup_task_struct(struct task_struct *orig, int node)
{
    struct task_struct *tsk;
    unsigned long *stack;
    struct vm_struct *stack_vm;

    /* 1. 从 task_struct 的 kmem_cache 分配新 task_struct */
    tsk = alloc_task_struct_node(node);
    if (!tsk) return NULL;

    /* 2. 分配内核栈 */
    stack = alloc_thread_stack_node(tsk, node);
    if (!stack) goto free_task;
    tsk->stack = stack;

    /* 3. 复制父进程的 task_struct(逐字节复制) */
    err = arch_dup_task_struct(tsk, orig);
    if (err) goto free_stack;

    /* 4. 复制 thread_info(栈底的 thread_info) */
    *tsk->stack = *orig->stack;

    /* 5. 初始化引用计数和统计 */
    refcount_set(&tsk->usage, 1);
    tsk->stack_canary = get_random_canary();  /* 栈溢出保护 */

    return tsk;
}
内核栈的设计:
每个进程有一个内核栈,x86-64 下默认大小为 16KB(
THREAD_SIZE= 16KB,即 4 页)。当进程从用户态陷入内核态(系统调用、中断、异常)时,CPU 自动切换到该进程的内核栈。
内核栈的底部(低地址)存放
thread_info(在CONFIG_THREAD_INFO_IN_TASK下,thread_info 移到了 task_struct 中,但栈布局仍保留)。task_struct和内核栈在内存中是连续分配的,通过栈指针可以快速计算出task_struct的地址(current宏)。
current 宏的实现原理: x86-64 下,current 宏通过 percpu 变量 current_task 获取当前进程的 task_struct。在上下文切换时,调度器更新 current_task。这比通过栈指针计算更快(不需要对齐运算)。
3.3.5 copy_mm() 详解:地址空间的复制与共享
static int copy_mm(unsigned long clone_flags, struct task_struct *tsk)
{
    struct mm_struct *mm, *oldmm;

    oldmm = current->mm;
    if (!oldmm) {
        /* 内核线程:mm 为 NULL,不需要复制 */
        tsk->mm = NULL;
        tsk->active_mm = NULL;
        return 0;
    }

    if (clone_flags & CLONE_VM) {
        /* 线程:共享地址空间,增加引用计数 */
        mmget(oldmm);
        mm = oldmm;
        goto good_mm;
    }

    /* 进程:复制地址空间(写时复制) */
    retval = dup_mm(tsk);
    if (retval) return retval;
    return 0;

good_mm:
    tsk->mm = mm;
    tsk->active_mm = mm;
    return 0;
}
dup_mm() 的 COW 实现:
static struct mm_struct *dup_mm(struct task_struct *tsk)
{
    struct mm_struct *mm, *oldmm = current->mm;

    /* 1. 分配新的 mm_struct */
    mm = allocate_mm();
    memcpy(mm, oldmm, sizeof(*mm));  /* 复制 mm_struct 内容 */

    /* 2. 初始化新 mm 的字段 */
    mm->mmap = NULL;
    mm->mm_rb = RB_ROOT;
    mm->mm_users = ATOMIC_INIT(1);
    mm->mm_count = ATOMIC_INIT(1);
    INIT_LIST_HEAD(&mm->mmlist);
    /* ... */

    /* 3. 复制页全局目录(PGD) */
    mm->pgd = pgd_alloc(mm);

    /* 4. 复制所有 VMA */
    retval = dup_mmap(mm, oldmm);
    /* dup_mmap 遍历父进程的所有 VMA,为每个 VMA 创建副本,
       并复制页表项(标记为只读,实现 COW) */

    return mm;
}
COW 的关键:dup_mmap() 复制 VMA 和页表时,将所有页表项标记为只读(清除写位)。这样父子进程都可以读这些页,但任何一方写入时都会触发写保护缺页,内核在缺页处理中执行 wp_page_copy() 复制该页。这就是 fork 高效的根本原因:不复制物理页,只复制页表,通过 COW 按需复制。
3.3.6 copy_thread():架构相关的上下文初始化
copy_thread() 是架构相关的,x86 下在 arch/x86/kernel/process.c(32 位与 64 位共用):
int copy_thread(unsigned long clone_flags, unsigned long sp,
                unsigned long arg, struct task_struct *p, unsigned long tls)
{
    struct pt_regs *childregs = task_pt_regs(p);
    struct fork_frame *fork_frame = container_of(childregs, struct fork_frame, regs);
    struct inactive_task_frame *frame = &fork_frame->frame;

    /* 1. 构造第一次调度时使用的内核栈帧,返回到 ret_from_fork */
    frame->bp = encode_frame_pointer(childregs);
    frame->ret_addr = (unsigned long)ret_from_fork;
    p->thread.sp = (unsigned long)fork_frame;  /* 内核栈指针 */

    /* 2. 复制父进程的寄存器上下文(pt_regs) */
    *childregs = *current_pt_regs();
    childregs->ax = 0;  /* 子进程的 fork 返回值为 0 */

    /* 3. 设置子进程的用户栈指针(clone 传入) */
    if (sp)
        childregs->sp = sp;

    /* 4. 设置线程本地存储 TLS(指定 CLONE_SETTLS 时) */
    if (clone_flags & CLONE_SETTLS)
        ret = set_new_tls(p, tls);

    return 0;
}
关键设计:
子进程的
fork()返回值被设置为 0(childregs->ax = 0),而父进程的返回值是子进程的 PID。这是通过在copy_thread中修改子进程的ax寄存器实现的。子进程第一次被调度时,从
ret_from_fork开始执行(frame->ret_addr),而不是从copy_thread的返回地址。ret_from_fork会恢复寄存器上下文,然后返回用户态。内核线程的
copy_thread不同:内核线程的入口是kernel_thread_helper,参数是fn和arg,没有用户态上下文。
3.3.7 wake_up_new_task():唤醒新进程
void wake_up_new_task(struct task_struct *p)
{
    struct rq_flags rf;
    struct rq *rq;

    /* 1. 设置进程状态为 TASK_RUNNING(5.15 的状态字段名为 __state) */
    WRITE_ONCE(p->__state, TASK_RUNNING);

    /* 2. 选择运行的 CPU(负载均衡) */
    rq = __task_rq_lock(p, &rf);
    update_rq_clock(rq);

    /* 3. 激活任务,加入运行队列 */
    activate_task(rq, p, ENQUEUE_NOCLOCK);
    /* 内部调用 sched_class->enqueue_task(),CFS 下是 enqueue_entity() */

    /* 4. 检查是否需要抢占当前进程 */
    check_preempt_curr(rq, p, WF_FORK);

    task_rq_unlock(rq, p, &rf);
}
新进程被加入运行队列后,调度器会在合适的时机选择它运行。如果新进程的优先级高于当前运行的进程,check_preempt_curr() 会设置需要调度标志,触发抢占。
3.4 进程退出与回收
3.4.1 进程退出流程
进程退出通过 exit() 系统调用,核心函数是 do_exit():
do_exit()
  │
  ├─ 1. 设置进程标志 PF_EXITING
  │
  ├─ 2. 退出定时器、性能事件、监控
  │
  ├─ 3. 释放当前任务持有的主要资源
  │     ├─ exit_mm()              解除地址空间引用;最后一个用户负责释放 mm
  │     ├─ exit_files()           释放文件描述符表引用
  │     ├─ exit_fs()              释放文件系统上下文引用
  │     ├─ exit_task_namespaces() 释放命名空间引用
  │     └─ cgroup_exit()          完成 cgroup 退出处理
  │
  ├─ 4. exit_notify() 处理父子关系、发送退出通知,并设置最终 exit_state
  │     - 常见情况进入 EXIT_ZOMBIE,保留退出状态等待父进程回收
  │     - 某些无需父进程回收的情况可直接进入 EXIT_DEAD
  │
  ├─ 5. 调用 schedule() 切换到其他进程
  │     (当前任务从此不再返回用户态)
  │
  └─ 6. 父进程 wait() 后由 release_task() 清理剩余 task_struct、PID 和信号结构等资源
3.4.2 僵尸进程与孤儿进程
僵尸进程(Zombie):进程已退出,但父进程尚未调用
wait()/waitpid()回收其task_struct和退出状态。僵尸进程不再占用 CPU,地址空间和打开文件等主要资源也已释放,但仍保留内核任务记录、PID 与退出状态等少量信息。如果父进程不回收,僵尸进程会积累,最终耗尽 PID。孤儿进程(Orphan):父进程先于子进程退出,子进程会被同一 PID 命名空间中最近的 child subreaper 接管;若不存在这样的 subreaper,通常由该命名空间的 init 进程接管。新的父进程负责后续
wait()回收。
3.4.3 wait() 回收
父进程通过 wait()/waitpid() 系统调用回收子进程:
查找子进程链表,找到僵尸状态的子进程。
读取子进程的退出码和资源使用统计。
调用
release_task()释放子进程的task_struct和剩余资源。释放 PID。
如果没有僵尸子进程且设置了 WNOHANG,立即返回;否则阻塞等待子进程退出。
3.5 上下文切换详解
3.5.1 原理:什么是上下文切换
**上下文切换(Context Switch)**是指 CPU 从一个进程切换到另一个进程的过程。“上下文"指的是进程运行所需的全部 CPU 状态,包括:
程序计数器(PC/RIP):下一条要执行的指令地址
栈指针(SP/RSP):当前栈顶地址
通用寄存器(rax/rbx/rcx/…)
标志寄存器(RFLAGS)
页表基址(CR3)
浮点/向量寄存器(FPU/XMM/YMM)
段寄存器(FS/GS,用于 TLS)
上下文切换是多任务操作系统的核心机制,它让多个进程"分时复用"CPU,营造出"同时运行"的假象。
3.5.2 上下文切换的触发时机
时间片用完:时钟中断中,调度器发现当前进程时间片用完,触发调度。
进程主动睡眠:进程调用
sleep()、等待信号量/互斥量/等待队列时,主动调用schedule()。进程唤醒高优先级进程:一个进程唤醒了比当前进程优先级更高的进程,触发抢占。
系统调用返回:系统调用返回用户态时,检查
_TIF_NEED_RESCHED标志,如果设置了则调度。中断返回:中断处理完成返回时,同样检查调度标志。
3.5.3 context_switch() 详解
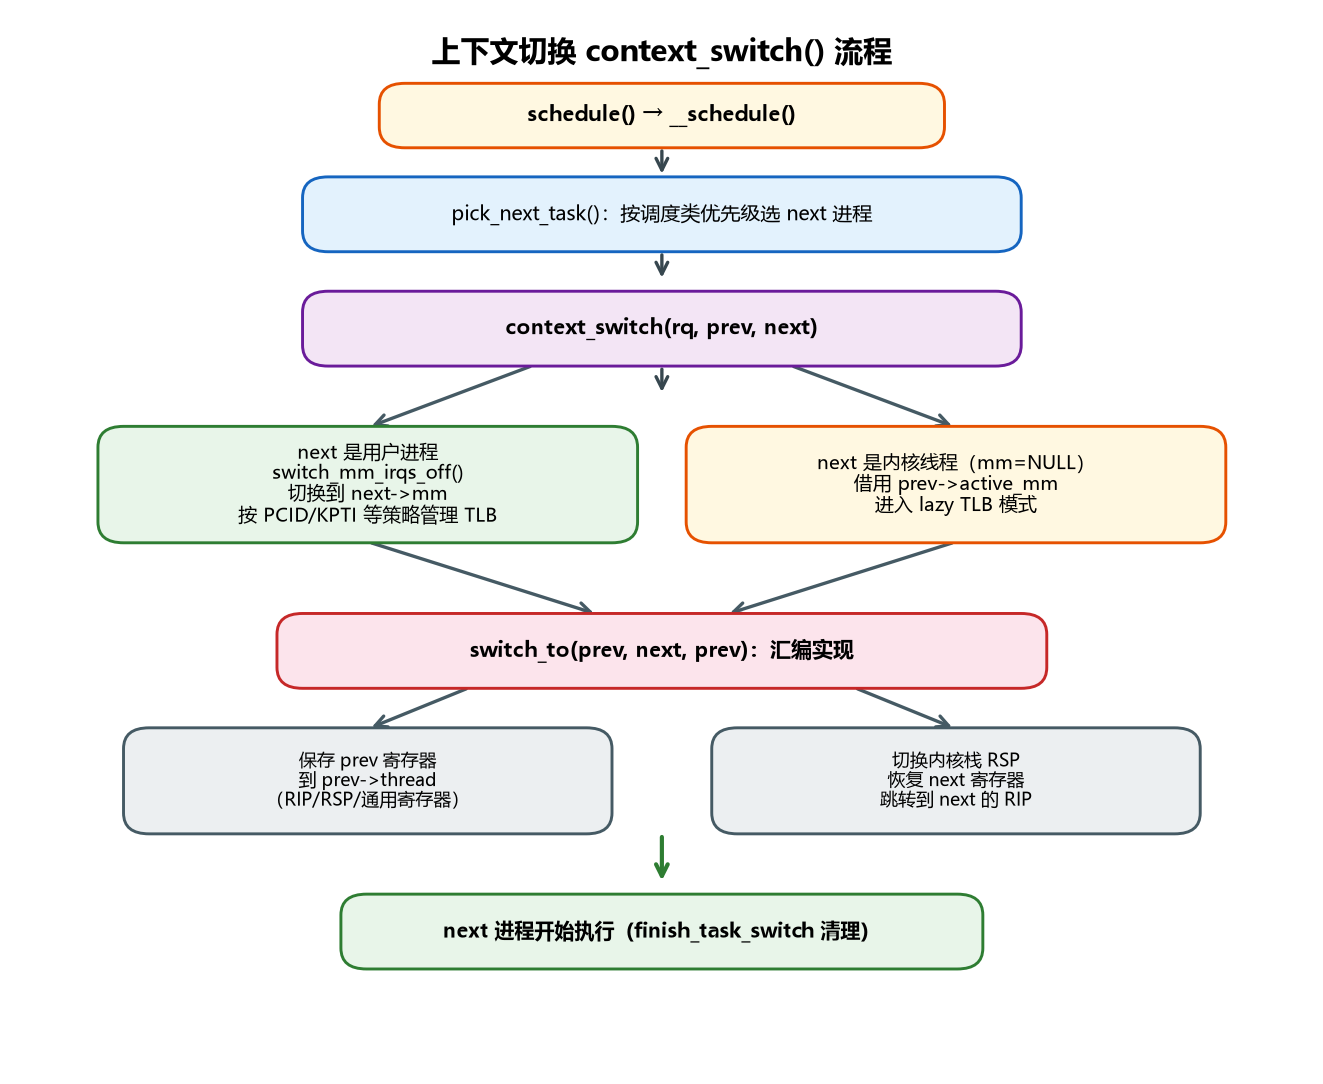
源码位置:kernel/sched/core.c
context_switch(struct rq *rq, struct task_struct *prev,
               struct task_struct *next)
{
    struct mm_struct *mm = next->mm;
    struct mm_struct *oldmm = prev->active_mm;

    /* 1. 切换地址空间(页表) */
    if (!mm) {
        /* 下一个是内核线程:没有自己的 mm,借用前一个进程的地址空间 */
        next->active_mm = oldmm;
        mmgrab(oldmm);  /* 增加引用计数,防止被释放 */
        enter_lazy_tlb(oldmm, next);  /* 懒 TLB 模式:不刷新用户态 TLB */
    } else {
        /* 下一个是用户进程:切换页表 */
        switch_mm_irqs_off(oldmm, mm, next);
        /* 内部:加载新进程的 pgd 到 CR3,刷新 TLB */
    }

    if (!prev->mm) {
        /* 前一个是内核线程:它借用的地址空间现在可以释放引用了 */
        prev->active_mm = NULL;
        mmdrop(oldmm);
    }

    /* 2. 切换寄存器和栈(架构相关,用汇编实现) */
    switch_to(prev, next, prev);

    /* switch_to 之后,当前进程已经是 next:
       下面的代码是在 next 被切换回来后执行的。
       prev 变量现在指向被切换出去的进程。 */

    /* 3. 切换后的清理(由 next 进程执行) */
    barrier();
    /* finish_task_switch() 会在后续调用中完成,
       释放 prev 的锁、处理 tick 等 */
}
3.5.4 switch_mm():页表切换
switch_mm() 是架构相关的,x86 下核心操作:
static inline void switch_mm(struct mm_struct *prev, struct mm_struct *next,
                              struct task_struct *tsk)
{
    if (prev != next) {
        /* 加载新进程的页全局目录物理地址到 CR3 寄存器 */
        write_cr3(next->pgd);
        /* 这会自动刷新 TLB(Translation Lookaside Buffer,地址翻译缓存) */
    }
    /* 更新 CPU 的 mm 状态、加载 LDT 等 */
}
TLB 的作用:TLB 是 MMU 中的高速缓存,存储最近使用的虚拟页到物理页帧的映射。切换 CR3 后,旧的 TLB 条目失效,需要刷新(x86 下写 CR3 自动刷新非全局 TLB 条目)。TLB 刷新是上下文切换的主要开销之一,因为刷新后后续的内存访问都需要重新遍历页表(慢)。
懒 TLB(Lazy TLB)优化:当切换到内核线程时,内核线程只访问内核空间,而内核空间的页表全局共享且不变。因此不需要刷新用户态 TLB,也不需要切换 CR3(直接借用前一个进程的页表)。这减少了 TLB 刷新的开销。
3.5.5 switch_to():寄存器与栈切换
switch_to 是一个宏,由架构相关的汇编代码实现(x86 下在 arch/x86/include/asm/switch_to.h)。它是上下文切换中最贴近硬件、也最依赖体系结构的部分。
x86-64 的 switch_to 实现逻辑:
#define switch_to(prev, next, last)                 \
do {                                                  \
    /* 1. 保存 prev 的 FPU 状态(延迟保存,按需) */ \
    /* ... */                                          \
                                                       \
    /* 2. 调用 __switch_to_asm(汇编) */             \
    ((struct task_struct *(*)                         \
        (struct task_struct *, struct task_struct *)) \
        __switch_to_asm)(prev, next);                 \
} while (0)
__switch_to_asm 汇编逻辑:
__switch_to_asm:
    /* 保存 prev 的通用寄存器到 prev->thread */
    pushq %rbp
    pushq %rbx
    pushq %r12
    pushq %r13
    pushq %r14
    pushq %r15

    /* 切换内核栈:将 next->thread.sp 加载到 rsp */
    movq %rsp, TASK_thread_sp(%rdi)  /* 保存 prev 的栈指针 */
    movq TASK_thread_sp(%rsi), %rsp  /* 加载 next 的栈指针 */

    /* 调用 C 函数 __switch_to 做剩余工作(TLS、FS/GS 等) */
    call __switch_to

    /* 恢复 next 的通用寄存器(从 next->thread) */
    popq %r15
    popq %r14
    popq %r13
    popq %r12
    popq %rbx
    popq %rbp

    ret  /* 返回到 next 的指令指针(next 上次被切换时保存的返回地址) */
为什么需要三个参数:switch_to(prev, next, prev) 使用了三个参数,其中 prev 出现两次。这是因为:
调用
switch_to时,prev是当前进程(被切换出去),next是下一个进程。switch_to内部切换栈后,执行流跳到了next的上下文。当
prev将来被重新调度回来时,它从switch_to的返回点继续执行,但此时它已经不知道自己是谁了(因为栈切换了)。第三个参数
last(也是prev)通过寄存器传递,在__switch_to中被设置为实际被切换出去的进程。这样prev进程被切换回来后,可以通过last知道自己之前切换到了哪个进程。
这是一个经典的"你以为你在调用函数,其实你在切换执行流"的设计。
3.5.6 x86 扩展寄存器状态的保存与恢复
FPU、XMM、YMM、ZMM 等扩展寄存器状态体积较大,由 x86 的 xstate/FPU 代码单独管理。Linux 5.15.220 的上下文切换不是早期内核那种“设置 CR0.TS,等任务首次执行浮点指令触发 #NM 后再保存前任状态”的传统 lazy FPU switching。
当前路径在 __switch_to() 周围调用 switch_fpu_prepare() 保存需要保存的前一任务状态,并由 switch_fpu_finish() 为下一任务建立所有权/装载状态。若下一任务的寄存器映像尚未装入,内核设置 TIF_NEED_FPU_LOAD,在返回用户态前通过 switch_fpu_return() 完成恢复。这样既保持状态隔离,又尽量避免不必要的重复装载。相关代码位于 arch/x86/kernel/process_64.c、arch/x86/include/asm/fpu/internal.h 和 arch/x86/include/asm/entry-common.h。
3.6 中断与异常处理
3.6.1 中断的分类
中断是 CPU 与外设交互、处理异常的核心机制。Linux 中的中断分为:
硬件中断(IRQ):由外设通过中断控制器(APIC)触发,如网卡收包、磁盘 IO 完成、键盘输入。
软件中断(异常/Exception):由 CPU 执行指令时触发,如缺页异常(#PF)、除零(#DE)、系统调用(#SYSCALL)。
软中断(Softirq):内核内部的延迟处理机制,用于将中断处理的耗时部分推迟到开中断环境执行。
3.6.2 硬中断处理流程
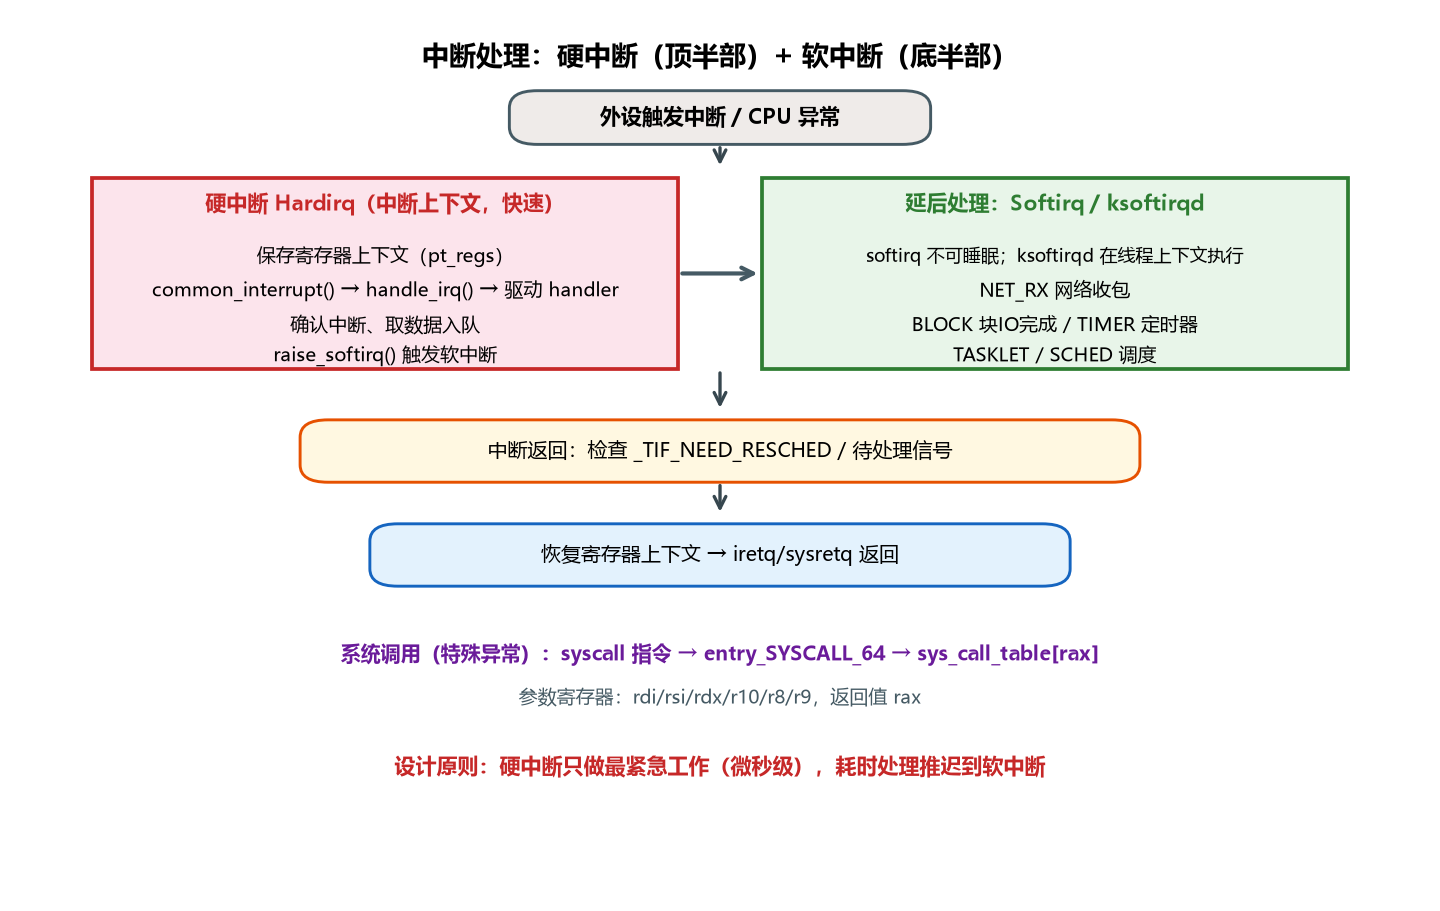
外设触发中断 → 中断控制器(APIC)路由到 CPU
  → x86 IDT 入口代码建立 pt_regs 上下文并进入 irqentry 框架
  → common_interrupt()
    → 根据本 CPU 的 vector_irq[vector] 找到 irq_desc
    → handle_irq() → generic_handle_irq_desc()
      → irq_desc 的 flow handler 处理屏蔽/确认等芯片细节
      → handle_irq_event() 调用驱动注册的 irqaction
        → 驱动 hardirq 快速确认中断、取走状态并安排后续处理
      → 如需延后处理,raise_softirq() 标记相应软中断
  → irqentry_exit() / 汇编返回路径处理待办工作并恢复寄存器
  → 返回被中断的内核或用户上下文
3.6.3 软中断(Softirq)机制
硬中断上下文应尽量快速完成,但耗时工作通常需要延后。Linux 常把设备中断处理拆成:
硬中断处理(hardirq):在中断上下文中完成确认设备、读取状态和安排后续处理;本地中断何时重新打开由入口代码和体系结构实现控制,不能笼统理解为整个 hardirq 都“全局关中断”。
延后处理:网络等子系统常用 softirq/NAPI 批量处理。softirq 运行时通常允许硬中断进入,但 softirq 上下文本身不可睡眠,是否可被普通任务抢占还取决于内核抢占模型和是否由
ksoftirqd在线程上下文处理。
软中断类型包括:
NET_RX_SOFTIRQ:网络收包处理NET_TX_SOFTIRQ:网络发包处理BLOCK_SOFTIRQ:块 IO 完成处理TIMER_SOFTIRQ:定时器处理TASKLET_SOFTIRQ:tasklet 处理SCHED_SOFTIRQ:调度器相关
软中断的执行时机:
硬中断返回时(
irq_exit→invoke_softirq)。ksoftirqd内核线程(当软中断处理时间过长时,由内核线程接管)。主动调用
local_bh_enable()时。
3.6.4 系统调用
系统调用是用户态程序请求内核服务的唯一合法入口。x86-64 下使用 syscall 指令:
用户态调用约定:
rax:系统调用号rdi:第 1 个参数rsi:第 2 个参数rdx:第 3 个参数r10:第 4 个参数(不是 rcx,因为 syscall 指令会用 rcx 保存返回地址)r8:第 5 个参数r9:第 6 个参数返回值在
rax
内核处理流程:
用户态执行 syscall 指令
  → CPU 自动切换到内核态,加载内核栈(MSR_LSTAR 指向入口)
  → 保存返回地址(rcx)和标志(r11)
  → entry_SYSCALL_64(汇编入口)
    → 保存用户态寄存器到 pt_regs
    → 检查系统调用号合法性
    → 调用系统调用表(sys_call_table)中对应的内核函数
      → 如 sys_read()、sys_write()、sys_fork() 等
    → 将返回值写入 pt_regs.ax
    → syscall_return_slowpath / syscall_return_fastpath
      → 检查是否需要调度、信号处理
      → 恢复用户态寄存器
      → sysretq 返回用户态
系统调用表:sys_call_table 是一个函数指针数组,索引是系统调用号,值是对应的内核处理函数。x86-64 下定义在 arch/x86/entry/syscall_64.c,系统调用号定义在 arch/x86/entry/syscalls/syscall_64.tbl。
3.7 进程管理子系统总结
用户态 fork()/clone()/pthread_create()
        │
        ▼  系统调用
kernel_clone()
  → copy_process()
    ├─ dup_task_struct()   分配 task_struct + 内核栈
    ├─ sched_fork()         调度初始化
    ├─ copy_mm()            复制/共享地址空间(COW)
    ├─ copy_files()         复制/共享文件描述符
    ├─ copy_sighand()       复制/共享信号处理
    ├─ copy_namespaces()    复制/共享命名空间
    ├─ copy_thread()        架构相关:设置寄存器和栈
    └─ alloc_pid()          分配 PID
  → wake_up_new_task()      加入运行队列

调度器选中新进程
  → context_switch()
    ├─ switch_mm()          切换页表(CR3),刷新 TLB
    └─ switch_to()          切换寄存器和内核栈(汇编)
      → 新进程从 ret_from_fork 开始执行

进程退出
  → do_exit()
    ├─ 释放 mm/files/fs/signal 等资源
    └─ 进入僵尸状态,等待父进程 wait() 回收
本章要点:
统一抽象:进程和线程都用
task_struct,通过 clone flags 区分,简化内核设计。写时复制:fork 不复制物理页,只复制页表并标记只读,按需复制,大幅提高效率。
惰性优化:懒 TLB(内核线程不刷新 TLB)、延迟 FPU 保存(不使用浮点就不保存)。
分层中断处理:硬中断快速响应,软中断延迟处理,兼顾响应性和吞吐量。
资源逐项复制:copy_process 逐项复制/共享各类资源,每项独立可控。
DISCUSSION
评论