WRITING
第二章 内存管理子系统
第二章 内存管理子系统
2.1 操作系统原理:虚拟内存的本质
2.1.1 为什么需要虚拟内存
在早期的计算机中,程序直接使用物理内存地址。这带来了几个严重问题:
内存碎片:多个程序连续分配和释放内存后,物理内存会产生大量外部碎片,虽然总空闲内存足够但无法分配连续的大块内存。
缺乏保护:程序可以直接访问任意物理地址,恶意程序可以读写其他程序甚至操作系统的内存,系统安全性无法保证。
程序加载困难:程序必须加载到连续的物理内存区域,当内存空间不足时程序无法运行。
无法高效利用内存:程序必须全部加载到内存才能运行,即使大部分代码暂时用不到也占用内存。
虚拟内存(Virtual Memory) 的引入解决了上述所有问题。其核心思想是:程序使用虚拟地址,操作系统和硬件(MMU)负责将虚拟地址翻译为物理地址。
2.1.2 虚拟内存的核心机制
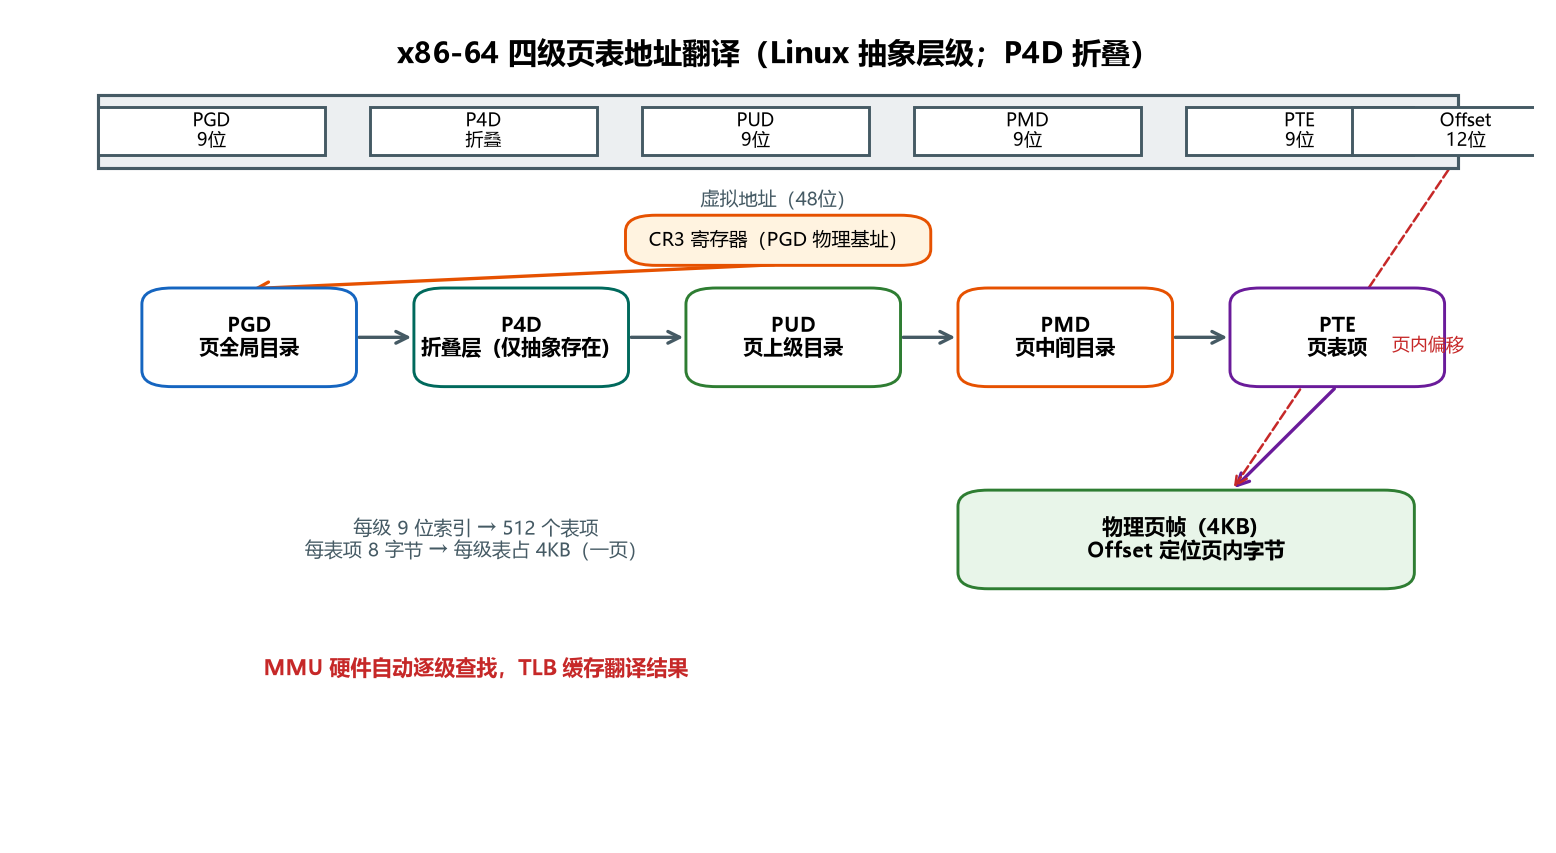
虚拟内存的实现依赖三个核心机制的配合:
(1)地址翻译与分页(Paging)
虚拟地址空间被划分为固定大小的页(Page,通常 4KB),物理内存也被划分为同样大小的页帧(Page Frame)。操作系统通过页表(Page Table)记录虚拟页到物理页帧的映射关系。
CPU 中的内存管理单元(MMU)在每次内存访问时自动完成地址翻译:
CPU 发出虚拟地址
MMU 查找页表,得到物理地址
用物理地址访问内存
这个过程对程序完全透明。
(2)缺页异常(Page Fault)
并非所有虚拟页都需要在程序运行时就映射到物理内存。当程序访问一个尚未映射的虚拟地址时,MMU 无法在页表中找到有效映射,会触发缺页异常(Page Fault),陷入内核。
内核的缺页异常处理程序会:
检查该虚拟地址是否合法(是否属于进程的地址空间)
如果合法,分配物理页帧,建立页表映射
返回用户态,重新执行触发异常的指令
这使得按需分配(Demand Paging)成为可能:程序只有在真正访问某页时才为其分配物理内存。
(3)页面置换(Page Replacement)
当物理内存不足时,内核需要将一些不常用的页换出到磁盘(swap 分区或交换文件),释放物理内存给急需的进程。当被换出的页再次被访问时,又触发缺页异常,内核将其从磁盘读回内存。
这实现了内存的超额承诺(Overcommitment):进程的虚拟地址空间总和可以远大于物理内存大小,因为只有活跃的页才驻留在物理内存中。
2.1.3 虚拟内存带来的好处
进程隔离:每个进程有独立的页表,一个进程无法访问另一个进程的物理内存,实现了内存保护。
简化内存管理:进程看到的是连续的虚拟地址空间,无需关心物理内存的碎片问题。
高效内存利用:通过按需分配和页面置换,只有活跃的页占用物理内存。
内存共享:多个进程可以映射同一个物理页帧(如共享库、进程间通信),只需在各自的页表中指向同一个物理页。
写时复制(COW):fork 子进程时不立即复制内存,而是让父子进程共享页并标记为只读,只有当某一方写入时才复制该页,大大提高了 fork 效率。
2.2 Linux 虚拟地址空间布局
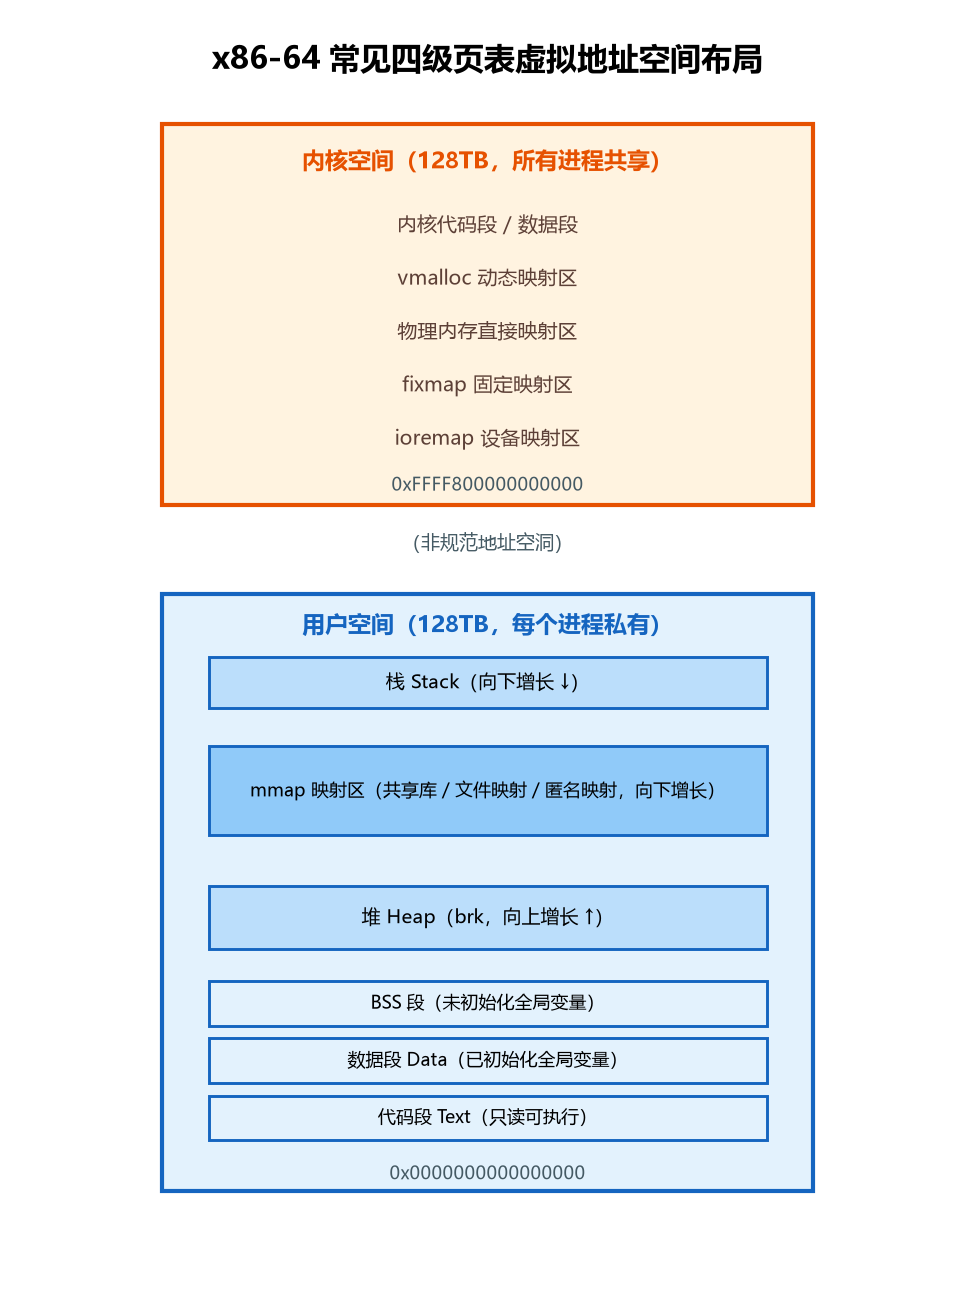
在 x86-64 架构下,Linux 的虚拟地址空间布局如下:
0xFFFFFFFFFFFFFFFF  ┌─────────────────────────┐
                     │ 内核高地址映射区(示意)    │
                     │  内核代码、数据、vmalloc、  │
                     │  直接映射区、fixmap 等       │
0xFFFF800000000000  ├─────────────────────────┤
                     │      (非规范地址空洞)      │
0x00007FFFFFFFFFFF  ├─────────────────────────┤
                     │                         │
                     │ 用户规范地址范围(示意)    │
                     │   栈(从高地址向下增长)     │
                     │   mmap 映射区(向下增长)    │
                     │   堆(从低地址向上增长)     │
                     │   BSS 段                    │
                     │   数据段                    │
                     │   代码段(从低地址开始)     │
0x0000000000000000  └─────────────────────────┘
关键特点:
x86-64 可使用四级或五级页表。常见四级页表配置使用 48 位规范虚拟地址:低 128TB 为用户地址范围,高地址区为内核映射;启用五级页表后,用户虚拟地址上限可扩展到 64PB,完整虚拟地址空间上限为 128PB。具体布局见
Documentation/x86/x86_64/mm.rst。用户空间从 0 开始,包含代码段、数据段、BSS、堆、mmap 区、栈。
内核空间所有进程共享,包含内核代码、内核数据结构、vmalloc 分配区、物理内存直接映射区等。
切换到不同
mm的进程时,架构代码切换相应地址空间(x86 通常涉及 CR3/PCID 与 TLB 管理)。内核映射在各进程页表中保持一致或通过页表隔离机制另行安排;是否刷新 TLB 以及如何保留条目取决于 PCID、KPTI 和体系结构实现,不能简单概括为“只切用户页表”。
2.3 核心数据结构详解
2.3.1 struct page — 物理页帧描述符
源码位置:include/linux/mm_types.h
每个物理页帧对应一个 struct page,内核通过它跟踪页的状态。这是内存管理中最基础、最重要的数据结构。
struct page {
    unsigned long flags;        /* 页标志位,原子操作更新 */
    union {
        struct {  /* 页缓存和匿名页使用 */
            struct list_head lru;          /* LRU 链表节点 */
            struct address_space *mapping;  /* 文件页指向 address_space;匿名页编码 anon_vma */
            pgoff_t index;                  /* 在 mapping 中的偏移(页为单位) */
            unsigned long private;          /* 私有数据(如 buffer_head、swap entry) */
        };
        struct {  /* slab/slub 分配器使用 */
            struct list_head slab_list;
            struct kmem_cache *slab_cache;  /* 所属的 slab cache */
            void *freelist;                 /* 空闲对象链表头 */
            void *s_mem;                    /* 第一个对象的起始地址 */
        };
        struct {  /* 复合页(compound page)的尾页 */
            unsigned long compound_head;    /* 指向首页(第0位为1标记尾页) */
            unsigned char compound_dtor;    /* 析构函数索引 */
            unsigned char compound_order;   /* 复合页的阶数 */
            atomic_t compound_mapcount;     /* 映射计数 */
        };
        /* ... 其他联合体成员(页表页、ZONE_DEVICE 等) */
    };
    /* 引用计数 _refcount、映射计数 _mapcount 等 */
};
设计要点:
为什么用 union? 一个物理页在同一时刻只属于一种用途:要么是页缓存/匿名页,要么是 slab 页,要么是复合页的尾页。使用 union 可以让不同用途复用同一块内存,将
struct page的大小控制在约 64 字节(一个缓存行)。这一点很关键,因为一个 16GB 内存的系统有 400 万个页,struct page数组本身就占用约 256MB 内存,每增加一个字段都是巨大的开销。flags 标志位:使用位标志表示页的各种状态,常见标志包括:
PG_locked:页被锁定,用于 IO 同步PG_dirty:页被修改,需要写回磁盘PG_active/PG_inactive:页在活跃/不活跃 LRU 链表上PG_slab:页用于 slab 分配器PG_buddy:页在 buddy 系统的空闲链表中PG_swapcache:页在 swap 缓存中PG_uptodate:页数据已从磁盘读入且有效PG_referenced:页最近被引用过(用于 LRU 回收决策)
mapping字段的双重含义:文件页通常把mapping指向所属的address_space;匿名页通常把它指向相应的anon_vma,同时置上PAGE_MAPPING_ANON标志位。内核利用相关对象的对齐约束复用指针中已知为 0 的低位,以区分匿名页、可移动页等类型;因此不能用“mapping == NULL”来判断一页是否为匿名页。
2.3.2 struct zone — 内存区域
源码位置:include/linux/mmzone.h
物理内存被划分为多个区域(Zone),这是因为历史原因和硬件限制:某些设备只能访问特定范围的物理内存(如 ISA 设备只能访问 16MB 以下,32 位 PCI 设备只能访问 4GB 以下)。
struct zone {
    /* 只读字段 */
    unsigned long _watermark[NR_WMARK];  /* 水位线:min/low/high */
    unsigned long watermark_boost;
    long lowmem_reserve[MAX_NR_ZONES];    /* 低端内存保留量 */
    int node;                               /* 所属 NUMA 节点 */
    struct pglist_data *zone_pgdat;
    struct per_cpu_pages __percpu *per_cpu_pageset;  /* 每 CPU 页缓存 */
    unsigned long zone_start_pfn;          /* 区域起始页帧号 */
    unsigned long managed_pages;           /* buddy 系统管理的页数 */

    /* 读写字段(需要 zone->lock 保护) */
    spinlock_t lock;
    struct free_area free_area[MAX_ORDER];  /* buddy 空闲链表数组 */
    unsigned long nr_free_pages;            /* 空闲页数 */

    /* LRU 相关 */
    struct lruvec lruvec;                    /* LRU 链表集合(活跃/不活跃 × 匿名/文件) */

    /* 统计信息 */
    atomic_long_t vm_stat[NR_VM_ZONE_STAT_ITEMS];
    /* ... */
};
x86-64 下的区域划分:
区域 | 地址范围 | 用途 |
|---|---|---|
| 0~16MB | 老式 ISA 设备的 DMA(几乎不再使用) |
| 16MB~4GB | 只能寻址 32 位的设备(如部分 PCI 设备) |
| 4GB 以上 | 常规内存,大多数分配来自这里 |
水位线机制:
每个 zone 维护三个水位线,是内存回收的核心触发机制:
内存使用量 ↑
           │
     ┌─────┴─────┐  WMARK_HIGH(高水位)
     │  内存充足   │  高于此值:不回收,分配直接从 buddy 取
     ├───────────┤  WMARK_LOW(低水位)
     │  开始回收   │  低于此值:唤醒 kswapd 内核线程异步回收
     ├───────────┤  WMARK_MIN(最低水位)
     │  直接回收   │  低于此值:分配路径中直接回收(direct reclaim),
     │  (direct    │  甚至触发 OOM killer
     │   reclaim)  │
     └───────────┘  0
WMARK_MIN的计算基于系统内存大小,约为总内存的 1/1024(但有上下限)。它是"保命"的内存量,低于此值说明内存严重不足。记
tmp = max(MIN/4, 该 zone 托管页数 × watermark_scale_factor / 10000),其中watermark_scale_factor默认为 10。于是WMARK_LOW = MIN + tmp、WMARK_HIGH = MIN + 2tmp。只有在MIN/4这一项占主导时,LOW、HIGH 才近似为 MIN 的 1.25、1.5 倍,内存较大时主要由watermark_scale_factor一项决定。分配时会检查目标 zone 的空闲页是否高于水位线,如果低于则需要先回收或从其他 zone 分配。
lowmem_reserve 机制:高端 zone(如 NORMAL)分配失败时可以"借用"低端 zone(如 DMA32)的内存,但低端 zone 的内存更宝贵(因为设备 DMA 需要)。lowmem_reserve 规定了每个低端 zone 必须为自己保留的内存量,高端 zone 不能借用这部分保留内存。
2.3.3 struct mm_struct — 进程地址空间描述符
源码位置:include/linux/mm_types.h
每个进程(或线程组)拥有一个 mm_struct,完整描述其虚拟地址空间:
struct mm_struct {
    struct {
        struct vm_area_struct *mmap;    /* VMA 链表头(按地址排序) */
        struct rb_root mm_rb;            /* VMA 红黑树根 */
        u64 vmacache_seqnum;             /* 每线程 VMA 缓存序列号 */
        unsigned long mmap_base;         /* mmap 区域基地址 */
        unsigned long task_size;         /* 进程虚拟空间大小 */
        unsigned long highest_vm_end;     /* 最高 VMA 的结束地址 */
        pgd_t *pgd;                      /* 页全局目录(第一级页表的物理地址) */
        atomic_t mm_users;               /* 用户空间引用计数(线程数) */
        atomic_t mm_count;               /* 内核引用计数 */
        int map_count;                    /* VMA 数量 */
        struct rw_semaphore mmap_lock;   /* 地址空间读写信号量(原 mmap_sem) */
        spinlock_t page_table_lock;       /* 页表锁 */
        struct list_head mmlist;          /* 全局 mm 链表 */
        unsigned long hiwater_rss;        /* 历史最大 RSS */
        unsigned long hiwater_vm;         /* 历史最大虚拟内存 */
        unsigned long total_vm;           /* 总映射页数 */
        unsigned long locked_vm;          /* 锁定页数(mlock) */
        unsigned long pinned_vm;          /* 固定页数 */
        unsigned long data_vm;             /* 数据段页数 */
        unsigned long exec_vm;             /* 可执行段页数 */
        unsigned long stack_vm;            /* 栈页数 */
        unsigned long def_flags;           /* 默认 VMA 标志 */
        unsigned long start_code, end_code, start_data, end_data;
        unsigned long start_brk, brk, start_stack;
        unsigned long arg_start, arg_end, env_start, env_end;
    };
    /* ... NUMA 策略、统计信息等 */
};
设计要点:
pgd的作用:pgd指向该进程第一级页表(PGD)的物理地址。进程切换时,switch_mm()将新进程的pgd物理地址加载到 CPU 的 CR3 寄存器,MMU 从此使用新页表进行地址翻译。内核线程的mm为 NULL,它们借用前一个用户进程的页表(active_mm),因为内核线程只访问内核空间,而内核空间页表全局共享。mm_usersvsmm_count:这是两个不同的引用计数,初学者容易混淆:mm_users:统计有多少用户态线程在使用这个地址空间。调用mmget()/mmput()修改。当mm_users降为 0 时,说明没有用户线程了,内核会释放地址空间的用户部分(页表、VMA 等),同时mm_count减 1。mm_count:统计内核态对mm_struct本身的引用。调用mmgrab()/mmdrop()修改。mm_users本身也算一个mm_count引用。当mm_count降为 0 时,才真正释放mm_struct结构体内存。设计原因:内核线程可能临时借用一个用户进程的
mm(通过mmgrab),此时即使用户进程已经退出(mm_users=0),mm_struct也不能释放,直到内核线程用完(mmdrop)。
VMA 的双结构维护:VMA 同时维护在链表(
mmap,按地址排序)和红黑树(mm_rb)中:链表用于需要遍历所有 VMA 的场景(如
munmap时查找重叠区域、core dump时遍历所有映射)。红黑树用于快速查找某个虚拟地址所属的 VMA(如缺页异常时),时间复杂度 O(log n)。
此外还有
vmacache(每 CPU VMA 缓存),缓存最近访问的几个 VMA,因为程序的局部性原理,最近访问的 VMA 很可能再次被访问,缓存命中可以避免红黑树查找。
mmap_lock(原 mmap_sem):这是地址空间的读写信号量,保护 VMA 链表、红黑树和页表的修改。读操作(如缺页异常中查找 VMA)获取读锁,写操作(如 mmap/munmap/brk)获取写锁。5.15 版本将mmap_sem重命名为mmap_lock,但功能不变。
2.3.4 struct vm_area_struct(VMA)— 虚拟内存区域
源码位置:include/linux/mm_types.h
进程的虚拟地址空间不是一整块,而是被划分为多个虚拟内存区域(VMA),每个 VMA 是一段具有相同属性(权限、是否文件映射、是否匿名等)的连续虚拟地址区间。
struct vm_area_struct {
    unsigned long vm_start;          /* 起始虚拟地址(含) */
    unsigned long vm_end;            /* 结束虚拟地址(不含) */
    struct vm_area_struct *vm_next;  /* 链表后继 */
    struct vm_area_struct *vm_prev;  /* 链表前驱 */
    struct rb_node vm_rb;             /* 红黑树节点 */
    unsigned long rb_subtree_gap;     /* 子树中最大空闲间隙(用于快速找空洞) */
    struct mm_struct *vm_mm;          /* 所属地址空间 */
    pgprot_t vm_page_prot;            /* 页保护属性(读写执行位) */
    unsigned long vm_flags;           /* 标志位 */
    struct {
        struct rb_node rb;
        unsigned long rb_subtree_last;
    } shared;                          /* 共享映射的区间树节点 */
    struct list_head anon_vma_chain;  /* 匿名 VMA 链 */
    struct anon_vma *anon_vma;         /* 匿名 VMA 描述符 */
    const struct vm_operations_struct *vm_ops;  /* 操作函数表 */
    unsigned long vm_pgoff;           /* 文件偏移(页为单位) */
    struct file *vm_file;              /* 映射的文件(NULL=匿名映射) */
    void *vm_private_data;             /* 私有数据 */
};
常见的 VMA 标志(vm_flags):
标志 | 含义 |
|---|---|
| 可读 |
| 可写 |
| 可执行 |
| 共享映射(更改对其他进程可见) |
| 私有映射(写时复制) |
| 可以向下增长(栈) |
| 可以向上增长(某些架构的栈) |
| 锁定在内存(mlock) |
| 设备 IO 映射(ioremap) |
| fork 时不复制 |
| 允许的最大权限(mprotect 不能超过) |
vm_ops 函数表:不同类型的 VMA 使用不同的 vm_ops,这是面向对象的多态设计:
struct vm_operations_struct {
    void (*open)(struct vm_area_struct *vma);
    void (*close)(struct vm_area_struct *vma);
    vm_fault_t (*fault)(struct vm_fault *vmf);       /* 缺页处理 */
    vm_fault_t (*huge_fault)(struct vm_fault *vmf, enum page_entry_size pe_size);
    void (*map_pages)(struct vm_fault *vmf, const struct vm_area_struct *vma);
    /* ... */
};
匿名 VMA 使用
anon_vm_ops,其fault方法是do_anonymous_page(),分配零页。文件映射 VMA 使用文件系统提供的
vm_ops(如 ext4 的ext4_file_vm_ops),其fault方法从文件读取数据。设备映射 VMA 使用驱动提供的
vm_ops。
典型进程的 VMA 布局:
高地址 ─────────────────────────────────
        [栈]                    VM_GROWSDOWN | VM_READ | VM_WRITE
        [环境变量/参数]
        [mmap 映射区]            共享库、文件映射、匿名映射
        [堆]                    VM_GROWSUP(向上) | VM_READ | VM_WRITE
        [BSS 段]                VM_READ | VM_WRITE
        [数据段]                VM_READ | VM_WRITE
        [代码段]                VM_READ | VM_EXEC
低地址 ─────────────────────────────────
2.4 物理内存管理:Buddy 系统
2.4.1 原理:为什么需要 Buddy 系统
物理内存以页(4KB)为单位管理,但内核经常需要分配连续的物理页块(如设备 DMA 需要连续物理内存、大页需要 2MB 连续物理页)。如果简单地用 first-fit 或 best-fit 算法分配连续页块,会产生严重的外部碎片:虽然总空闲页足够,但都是分散的小块,无法分配大块连续内存。
Buddy(伙伴)系统是一种经典的内存分配算法,通过将空闲内存按 2 的幂次方大小分组,并在释放时自动合并相邻的空闲块,有效控制外部碎片。
2.4.2 Buddy 系统的核心数据结构
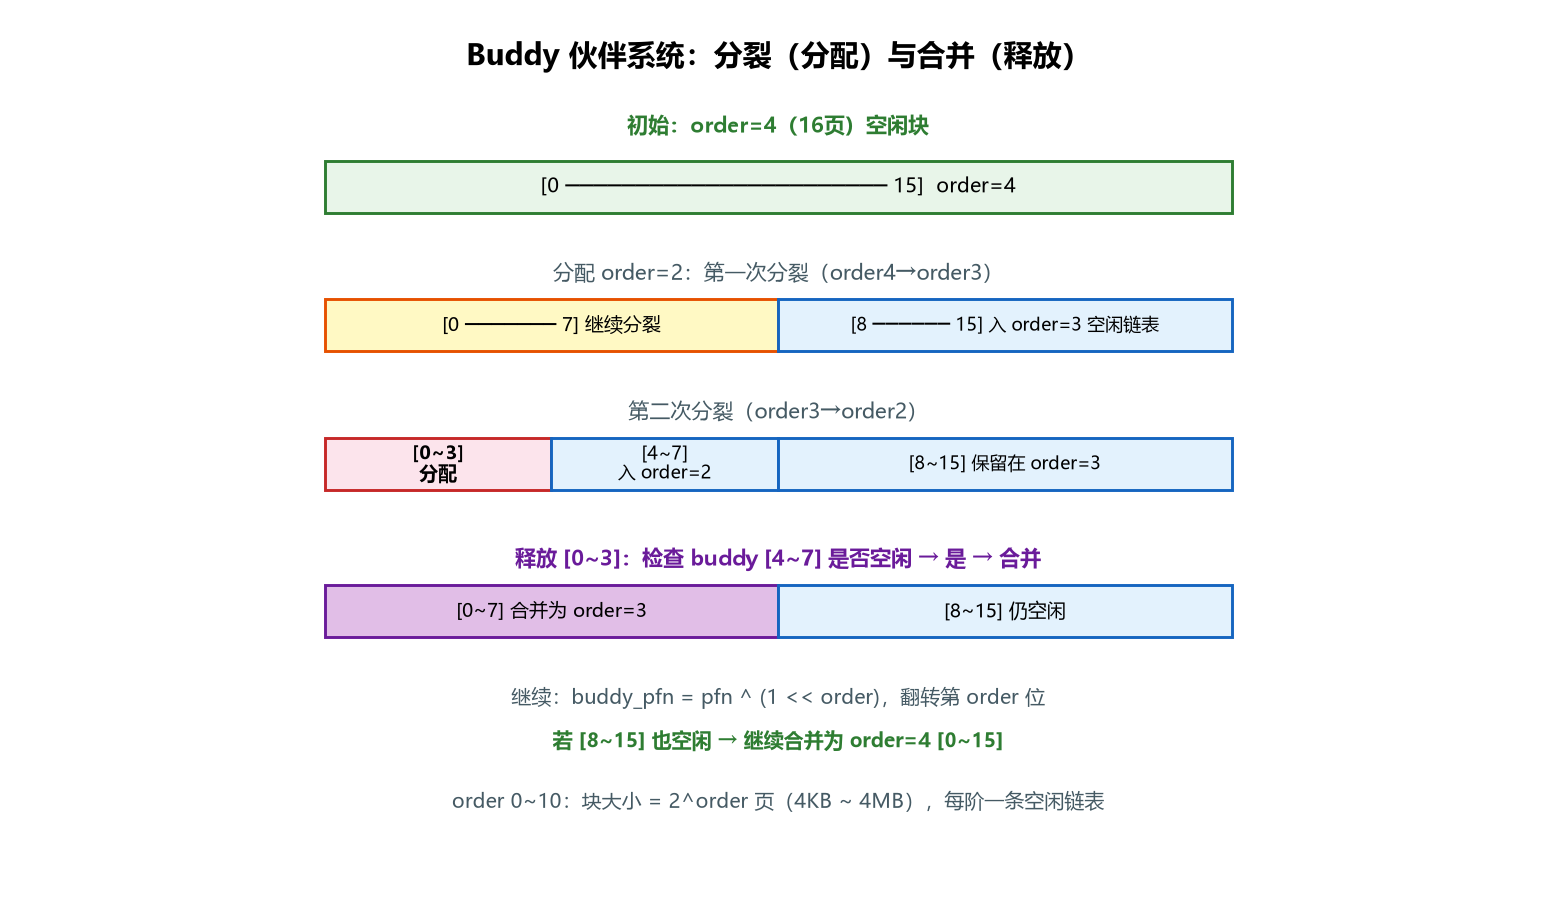
每个 zone 维护一个 free_area 数组,每个元素对应一个阶(order)的空闲链表:
#define MAX_ORDER 11  /* 最大阶数,order 0~10,最大块 4MB */

struct free_area {
    struct list_head free_list[MIGRATE_TYPES];  /* 按迁移类型分的空闲链表 */
    unsigned long nr_free;                        /* 该 order 的空闲块数量 */
};

struct zone {
    struct free_area free_area[MAX_ORDER];  /* buddy 空闲链表数组 */
};
关键设计:
order从 0 到MAX_ORDER-1(默认 10),order=k 表示块大小为2^k页。order=0:1 页(4KB)
order=1:2 页(8KB)
…
order=10:1024 页(4MB)
每个 order 的链表又按迁移类型(migratetype)分为多个子链表,减少不同类型页之间的碎片。
2.4.3 分配流程详解
分配一个 order=k 的块的算法:
在 order=k 的空闲链表中查找是否有空闲块。
如果有,取出一个块,分配完成。
如果没有,向上到 order=k+1 的链表查找。
如果找到一个大块,将其分裂为两个大小为
2^k的 buddy 块:一个用于分配,另一个加入 order=k 的空闲链表。如果 order=k+1 也没有,继续向上,直到找到为止。
如果最高 order 也没有,分配失败。
核心函数调用链:
alloc_pages(gfp_mask, order)          // 最常用的分配接口
  → alloc_pages_current()
    → __alloc_pages_nodemask()         // 分配的核心入口
      → get_page_from_freelist()       // 快速路径:从 zone 空闲链表分配
        → rmqueue()
          → rmqueue_buddy()
            → __rmqueue_smallest()     // 核心:找到最小合适的块并分裂
      → 快速路径失败 → __alloc_pages_slowpath()
        → 唤醒 kswapd 回收
        → direct reclaim(直接回收)
        → 压缩内存(compaction)
        → OOM killer
__rmqueue_smallest() 核心逻辑(mm/page_alloc.c):
static inline struct page *__rmqueue_smallest(struct zone *zone,
                                                unsigned int order,
                                                int migratetype)
{
    unsigned int current_order;
    struct free_area *area;
    struct page *page;

    /* 从请求的 order 开始,向上查找第一个有空闲块的 order */
    for (current_order = order; current_order < MAX_ORDER; ++current_order) {
        area = &(zone->free_area[current_order]);
        if (list_empty(&area->free_list[migratetype]))
            continue;  /* 该 order 该类型没有空闲块,继续向上 */

        /* 找到空闲块,从链表中移除 */
        page = list_first_entry(&area->free_list[migratetype],
                                 struct page, lru);
        list_del(&page->lru);

        /* 如果找到的块比请求的大,需要分裂 */
        if (current_order > order) {
            /* 将大块分裂为两个 buddy,逐级向下分裂,直到 order 级别 */
            expand(zone, page, order, current_order, migratetype);
        }

        set_pcppage_migratetype(page, migratetype);
        return page;
    }
    return NULL;  /* 所有 order 都没有空闲块 */
}
expand() 分裂函数:
static inline void expand(struct zone *zone, struct page *page,
                           int low, int high, int migratetype)
{
    unsigned long size = 1 << high;  /* 原始块大小(页数) */

    while (high > low) {
        high--;
        size >>= 1;  /* 块大小减半 */
        /* page + size 是 buddy 块的起始页 */
        struct page *buddy = page + size;
        /* 将 buddy 加入对应 order 的空闲链表 */
        list_add(&buddy->lru, &zone->free_area[high].free_list[migratetype]);
        set_buddy_order(buddy, high);
    }
}
分裂示例:请求 order=2(4 页),但只有 order=4(16 页)的空闲块:
初始:order=4 有一个 16 页的空闲块 [0, 15]

第一次分裂(high=4→3):
  [0, 7] 用于继续分裂,[8, 15] 加入 order=3 空闲链表

第二次分裂(high=3→2):
  [0, 3] 分配给请求,[4, 7] 加入 order=2 空闲链表

结果:分配 [0,3],空闲链表新增 [4,7](order=2) 和 [8,15](order=3)
2.4.4 释放与合并流程详解
释放一个 order=k 的块的算法:
计算该块的 buddy 块的页帧号:
buddy_pfn = pfn ^ (1 << order)(翻转第 k 位)。检查 buddy 是否也是空闲的(且在 buddy 系统中)。
如果 buddy 空闲,将 buddy 从空闲链表中移除,与当前块合并为一个 order=k+1 的块。
以合并后的块为基础,重复步骤 1-3,继续向上合并。
直到 buddy 不空闲或达到最大 order,将最终块加入对应 order 的空闲链表。
核心函数 __free_one_page()(mm/page_alloc.c):
static inline void __free_one_page(struct page *page,
                                    unsigned long pfn,
                                    struct zone *zone,
                                    unsigned int order,
                                    int migratetype,
                                    fpi_t fpi_flags)
{
    unsigned int max_order = min(MAX_ORDER - 1, pageblock_order);

    /* 更新 zone 空闲页计数 */
    __mod_zone_freepage_state(zone, 1 << order, migratetype);

continue_merging:
    while (order < max_order) {
        /* 计算 buddy 的页帧号:翻转第 order 位 */
        buddy_pfn = __find_buddy_pfn(pfn, order);
        buddy = page + (buddy_pfn - pfn);

        /* 检查 buddy 是否空闲且可合并 */
        if (!page_is_buddy(page, buddy, order))
            goto done_merging;

        /* buddy 空闲,从空闲链表移除 */
        del_page_from_free_list(buddy, zone, order);

        /* 合并:取两个块中地址较小的作为合并块起始 */
        combined_pfn = buddy_pfn & pfn;
        page = page + (combined_pfn - pfn);
        pfn = combined_pfn;
        order++;  /* 阶数加 1,继续尝试向上合并 */
    }

    /* 处理 pageblock 级别的合并(order >= pageblock_order) */
    if (order < MAX_ORDER - 1) {
        if (unlikely(has_isolate_pageblock(zone))) {
            /* 隔离类型的 pageblock 不能与普通类型合并 */
            buddy_pfn = __find_buddy_pfn(pfn, order);
            buddy = page + (buddy_pfn - pfn);
            buddy_mt = get_pageblock_migratetype(buddy);
            if (migratetype != buddy_mt &&
                (is_migrate_isolate(migratetype) || is_migrate_isolate(buddy_mt)))
                goto done_merging;
        }
        max_order = order + 1;
        goto continue_merging;
    }

done_merging:
    set_buddy_order(page, order);
    /* 将最终合并后的块加入空闲链表 */
    add_to_free_list(page, zone, order);
}
Buddy 查找原理:
__find_buddy_pfn(pfn, order) 的实现:
static inline unsigned long __find_buddy_pfn(unsigned long pfn, unsigned int order)
{
    return pfn ^ (1 << order);
}
为什么异或 1 << order 就能找到 buddy?
一个 order=k 的块大小是
2^k页,其起始页帧号一定是2^k的整数倍(即低 k 位为 0)。两个 buddy 块大小相同,地址连续,且它们的起始地址的第 k 位(从 0 开始数)一定不同(一个是 0,一个是 1),而更高位相同。
因此,翻转第 k 位就能从一个块的起始地址得到另一个 buddy 块的起始地址。
示例:order=2(4 页一块),pfn=0:
1 << 2 = 4(二进制 100)0 ^ 4 = 4,buddy 是 pfn=4pfn=4 的 buddy:
4 ^ 4 = 0,回到 pfn=0 ✓
合并示例:释放 order=2 的块 [0,3],假设 [4,7] 也空闲:
释放 [0,3](order=2):
  buddy_pfn = 0 ^ 4 = 4,检查 [4,7] 是否空闲 → 是
  合并为 [0,7](order=3),从 order=2 链表移除 [4,7]

继续合并(order=3):
  buddy_pfn = 0 ^ 8 = 8,检查 [8,15] 是否空闲 → 否
  停止合并,将 [0,7] 加入 order=3 空闲链表
2.4.5 迁移类型(MIGRATE_TYPES)
Buddy 系统的一个重要优化是迁移类型,用于减少碎片。每个空闲链表按迁移类型分为多个子链表:
类型 | 含义 | 特点 |
|---|---|---|
| 不可移动页 | 内核数据结构,物理地址固定不能移动 |
| 可移动页 | 用户页、页缓存,可以通过迁移移动物理地址 |
| 可回收页 | slab 等,可以回收后重新分配 |
| CMA 区域 | 连续内存分配器保留区域 |
| 高原子分配 | 为高优先级原子分配保留 |
| 隔离 | 内存热插拔、 compaction 临时隔离 |
为什么需要迁移类型? 如果不可移动页(如内核数据结构)和可移动页(如用户页)混在一起,不可移动页会"钉住"物理内存,阻碍大块连续内存的形成。通过将不同类型的页从不同的空闲链表分配,尽量让同类型的页聚集在一起,减少不可移动页对可移动区域的碎片化影响。
当某种类型的空闲链表为空时,可以从其他类型"借用"页,但有严格的优先级和保留机制。
2.4.6 Per-CPU 页缓存(pcp)
Buddy 系统的分配需要持有 zone->lock(自旋锁),在多 CPU 系统中这会成为瓶颈。为了减少锁竞争,Linux 引入了每 CPU 页缓存(per-CPU pageset,pcp):
每个 CPU 为每个 zone 维护一个 pcp,缓存一批 order=0 的单页。
分配单页时,先从本地 CPU 的 pcp 取,无需加锁。
pcp 为空时,从 buddy 系统批量分配一批页(
batch个,默认约 60-300)填充 pcp。释放单页时,先放回本地 pcp;pcp 满了(超过
high阈值)时,批量归还 buddy 系统。
这是典型的批处理 + 缓存优化,大大减少了锁竞争和分配开销。
2.5 小对象内存分配:SLUB 分配器
2.5.1 原理:为什么需要 SLUB
Buddy 系统以页(4KB)为最小分配单位,但内核中大量的数据结构(如 task_struct、file、inode、sk_buff 等)大小远小于一页。如果直接用 buddy 分配,会造成严重的内部碎片(分配 4KB 但只用 100 字节)。
SLUB 分配器在 buddy 系统之上构建了一层小对象分配机制:
为每种对象类型创建一个
kmem_cache(缓存),指定对象大小。每个 cache 从 buddy 申请一组连续页(称为 slab),然后在 slab 内切分成固定大小的对象。
维护空闲对象链表,分配时从链表取一个,释放时放回链表。
Linux 提供三种 slab 分配器:SLAB(传统)、SLUB(默认,性能更好)、SLOB(极简,用于嵌入式)。5.15 默认使用 SLUB。
2.5.2 核心数据结构
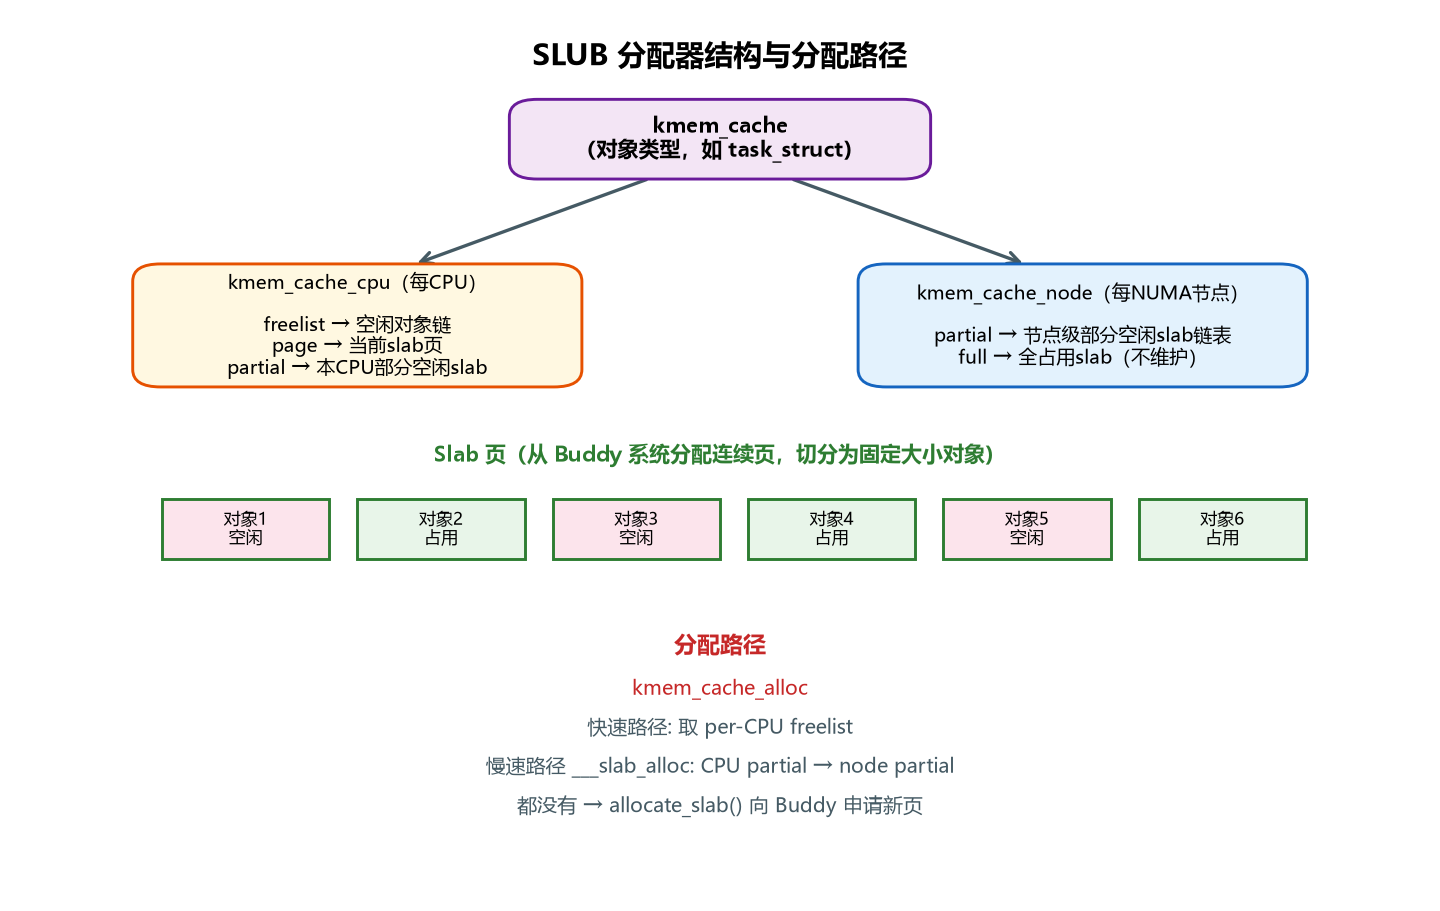
struct kmem_cache — 对象缓存:
struct kmem_cache {
    unsigned int size;             /* 对象大小(含对齐填充) */
    unsigned int object_size;       /* 实际对象大小(不含填充) */
    unsigned int offset;            /* 空闲指针在对象内的偏移 */
    unsigned int cpu_partial;       /* 每 CPU partial 数量上限 */
    gfp_t allocflags;               /* 分配标志 */
    int refcount;                    /* 引用计数 */

    /* 每 CPU 数据 */
    struct kmem_cache_cpu __percpu *cpu_slab;

    /* 每个 NUMA 节点的数据 */
    struct kmem_cache_node *node[MAX_NUMNODES];

    const char *name;               /* 缓存名称(如 "task_struct") */
    /* ... */
};
struct kmem_cache_cpu — 每 CPU 缓存:
struct kmem_cache_cpu {
    void **freelist;        /* 指向当前 slab 的空闲对象链表 */
    struct page *page;       /* 当前正在使用的 slab 页 */
    struct page *partial;    /* 本 CPU 的 partial slab 链表 */
    int tid;                 /* 事务 ID(用于无锁检测) */
};
struct kmem_cache_node — 每节点数据:
struct kmem_cache_node {
    spinlock_t list_lock;
    unsigned long nr_partial;        /* partial slab 数量 */
    struct list_head partial;         /* partial slab 链表 */
    unsigned long total_slabobjects;  /* 总对象数 */
    /* ... 统计信息 */
};
2.5.3 分配流程详解
调用链:
kmem_cache_alloc(cache, gfpflags)
  → slab_alloc_node(cache, gfpflags, node, addr)
    ├─ 快速路径:从当前 CPU 的 kmem_cache_cpu 取空闲对象
    │   (无需加锁,因为是每 CPU 数据)
    └─ 慢速路径:___slab_alloc()
        ├─ 当前 slab 没有空闲对象 → 从 CPU partial 链表找
        ├─ CPU partial 也没有 → 从节点 partial 链表找
        └─ 都没有 → new_slab() 从 buddy 系统申请新 slab
快速路径 slab_alloc_node()(mm/slub.c):
static __always_inline void *slab_alloc_node(struct kmem_cache *s,
                                               gfp_t gfpflags, int node,
                                               unsigned long addr, size_t orig_size)
{
    void *object;
    struct kmem_cache_cpu *c;
    struct page *page;
    unsigned long tid;

    /* 获取当前 CPU 的 kmem_cache_cpu */
    c = raw_cpu_ptr(s->cpu_slab);

    /* 快速路径:从 freelist 取一个对象 */
    do {
        tid = this_cpu_read(s->cpu_slab->tid);
        c = raw_cpu_ptr(s->cpu_slab);
        page = c->page;

        if (unlikely(!page || !c->freelist))
            goto slower;  /* 没有当前 slab 或没有空闲对象,走慢速路径 */

        /* 从 freelist 取第一个空闲对象 */
        object = c->freelist;
        c->freelist = get_freepointer(s, object);  /* freelist 指向下一个空闲对象 */

    } while (unlikely(!this_cpu_cmpxchg_double(s->cpu_slab->tid, ...)));

    return object;

slower:
    return ___slab_alloc(s, gfpflags, node, addr, c);
}
空闲对象链表的设计:SLUB 的空闲对象链表不是单独分配的,而是利用空闲对象自身的内存存储下一个空闲对象的指针。当对象空闲时,其内存的前几个字节存放 next 指针;当对象被分配后,这部分内存归用户使用。这就是 offset 字段的作用——指定空闲指针在对象内的偏移位置。
慢速路径 ___slab_alloc()(mm/slub.c):
static void *___slab_alloc(struct kmem_cache *s, gfp_t gfpflags, int node,
                            unsigned long addr, struct kmem_cache_cpu *c)
{
    struct page *page;
    void *freelist;

    /* 1. 重新读取当前 slab(可能被抢占后改变) */
    page = READ_ONCE(c->page);
    if (!page)
        goto new_slab;  /* 没有当前 slab,需要新建 */

    /* 2. 检查 node 匹配和 pfmemalloc 匹配 */
    if (!node_match(page, node))
        goto deactivate_slab;
    if (!pfmemalloc_match_unsafe(page, gfpflags))
        goto deactivate_slab;

    /* 3. 加锁后再次检查,从 slab 中获取空闲对象 */
    local_lock_irqsave(&s->cpu_slab->lock, flags);
    if (unlikely(page != c->page))
        goto reread_page;  /* 被抢占后改变了,重新读 */

    freelist = c->freelist;
    if (freelist)
        goto load_freelist;  /* per-cpu 有缓存的空闲对象 */

    /* 4. 从 slab 页中获取空闲对象链表 */
    freelist = get_freelist(s, page);
    if (!freelist) {
        c->page = NULL;  /* 当前 slab 已满,去 partial 或新建 */
        goto new_slab;
    }

load_freelist:
    /* 从 freelist 取一个对象,更新 freelist */
    object = freelist;
    c->freelist = get_freepointer(s, object);
    local_unlock_irqrestore(&s->cpu_slab->lock, flags);
    return object;

new_slab:
    /* 5. 从 CPU partial 链表找有空闲对象的 slab */
    /* 6. CPU partial 没有 → 从节点 partial 链表找 */
    /* 7. 都没有 → allocate_slab() 从 buddy 申请新 slab */
    /* ... */
}
新建 slab allocate_slab():
计算需要的页数:根据对象大小和
oo(order-object)参数,确定一个 slab 包含多少页、多少对象。调用
alloc_pages()从 buddy 系统分配连续页。初始化 slab:将页切分为对象,构建空闲对象链表。
将 slab 设为当前 CPU 的
c->page。
2.5.4 释放流程
kmem_cache_free(cache, object)
  → do_slab_free()
    ├─ 快速路径:将对象放回当前 slab 的 freelist(每 CPU,无锁)
    └─ 如果 slab 从 full 变为 partial → 加入 partial 链表
       如果 slab 对象全空闲 → 可能归还 buddy 系统(减少内存占用)
释放时同样利用对象内存存储 next 指针,将对象插入空闲链表头部。
2.5.5 SLUB 的设计优势
相比传统的 SLAB 分配器,SLUB 的优势:
更简单:去除了 SLAB 中复杂的
array_cache和shared_array,直接用 per-CPU 的kmem_cache_cpu。更少的元数据开销:SLAB 每个对象有
struct slab等额外元数据,SLUB 利用struct page的 union 字段存储 slab 信息,无需额外分配。更好的调试支持:SLUB 内置了调试功能(如 red zone、poisoning、用户跟踪),可以通过 boot 参数开启。
无锁快速路径:分配和释放的快速路径操作 per-CPU 数据,使用
cmpxchg_double实现无锁,性能优异。
2.6 缺页异常处理
2.6.1 原理:缺页异常的类型
当进程访问虚拟地址时,MMU 查找页表,如果遇到以下情况会触发缺页异常:
页不存在(PTE 为空):该虚拟页从未分配物理页,或被换出到 swap。
匿名页(堆、栈):分配一个全零页。
文件映射页:从文件读取数据到页。
swap 页:从 swap 分区读回页。
权限不足(PTE 存在但保护位不匹配):
写只读页:触发写时复制(COW),复制页后建立可写映射。
执行非可执行页:触发段错误(SIGSEGV)。
地址非法:该虚拟地址不属于任何 VMA,或访问权限不匹配 VMA 标志 → 发送 SIGSEGV 终止进程。
2.6.2 缺页异常的完整处理流程
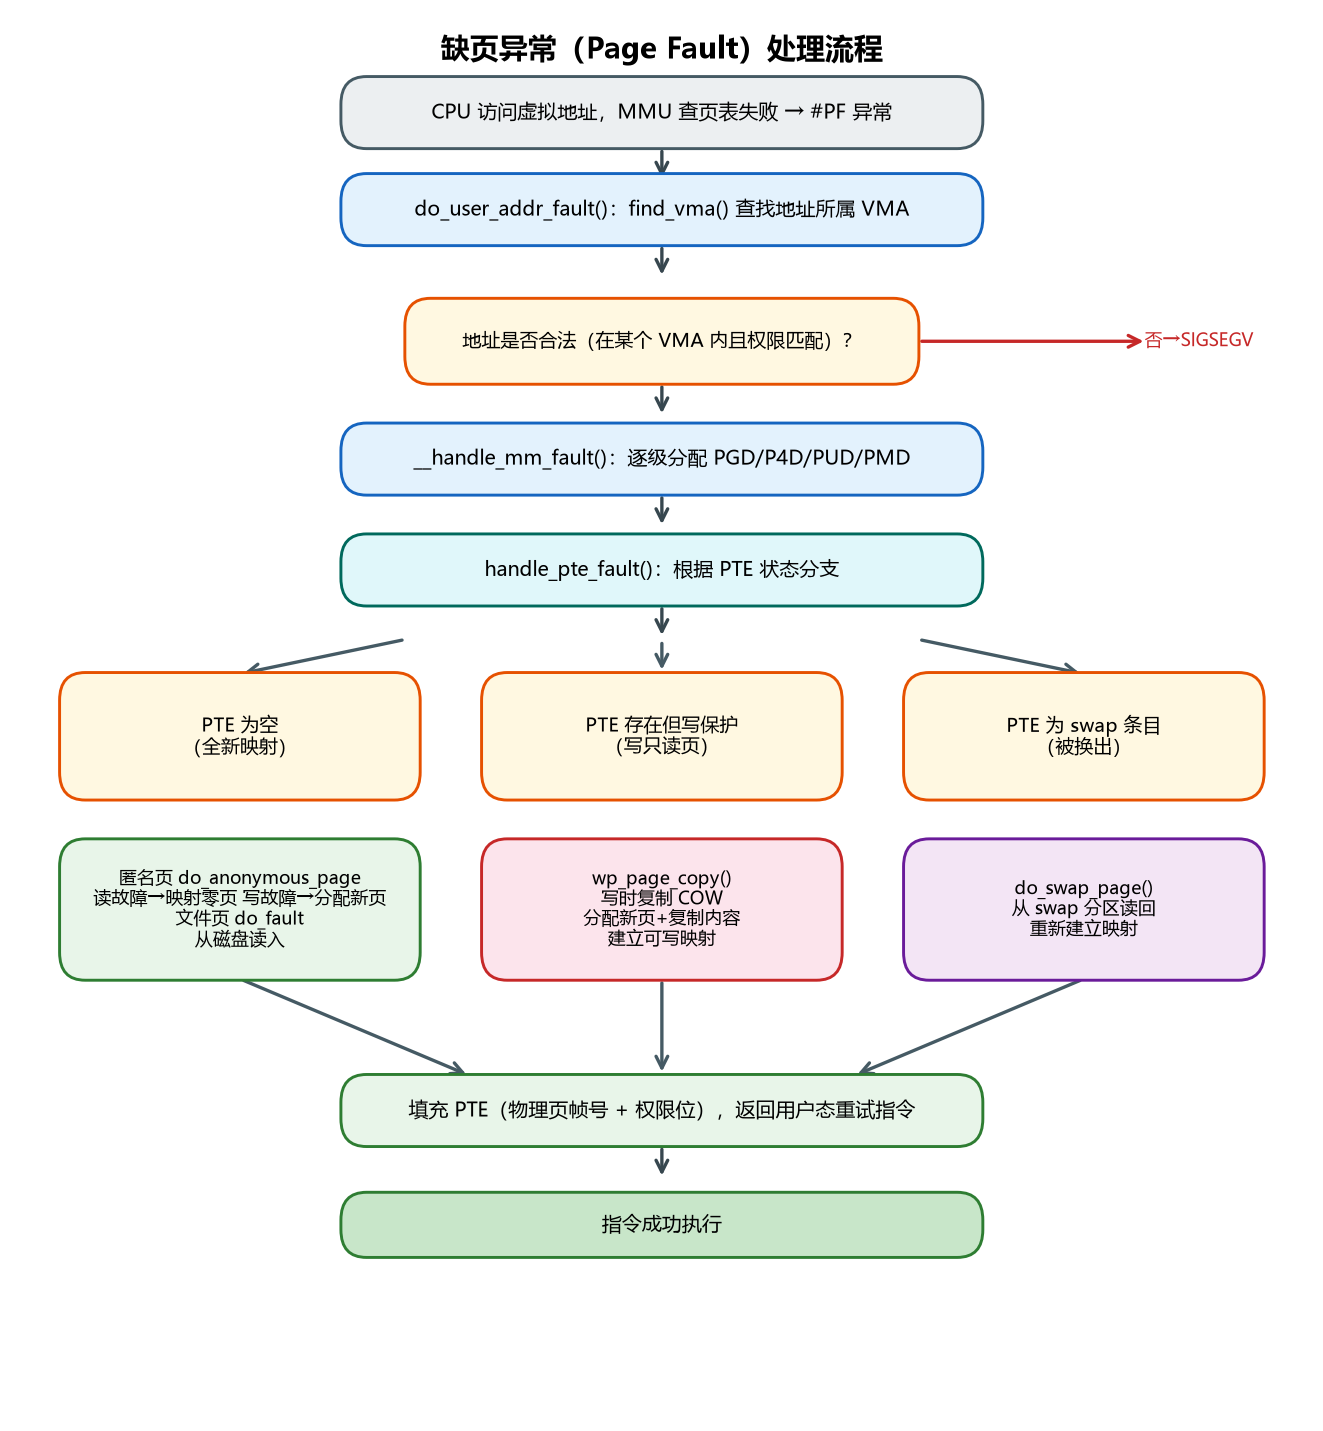
x86-64 架构下的调用链:
CPU 触发缺页异常(#PF)
  → 硬件自动切换到内核栈,压入错误码和指令地址
  → arch/x86/entry/entry_64.S: asm_exc_page_fault
    → exc_page_fault()
      → do_user_addr_fault()  [用户态缺页]
        ├─ 查找地址所属的 VMA(find_vma())
        ├─ 地址不合法 → 发送 SIGSEGV / SIGBUS
        └─ 地址合法 → handle_mm_fault()
          → __handle_mm_fault()
            ├─ 分配/建立各级页表(PGD → P4D → PUD → PMD)
            ├─ 透明大页处理(PUD/PMD 级别)
            └─ handle_pte_fault()
              ├─ PTE 不存在(全新映射)
              │   ├─ 匿名 VMA → do_anonymous_page()  分配零页
              │   ├─ 文件 VMA → do_fault() → 从文件读入
              │   └─ swap 条目 → do_swap_page()  从 swap 读回
              ├─ PTE 存在但写保护(COW)
              │   └─ wp_page_copy()  复制页并建立可写映射
              └─ PTE 存在但非可执行 → 错误
2.6.3 __handle_mm_fault() 详解
源码位置:mm/memory.c
static vm_fault_t __handle_mm_fault(struct vm_area_struct *vma,
                                      unsigned long address,
                                      unsigned int flags)
{
    struct vm_fault vmf = {
        .vma = vma,
        .address = address & PAGE_MASK,  /* 页对齐 */
        .flags = flags,
        .pgoff = linear_page_index(vma, address),  /* 文件偏移 */
        .gfp_mask = __get_fault_gfp_mask(vma),
    };
    struct mm_struct *mm = vma->vm_mm;
    pgd_t *pgd;
    p4d_t *p4d;

    /* 1. 找到或分配各级页表 */
    pgd = pgd_offset(mm, address);           /* PGD 项(第一级) */
    p4d = p4d_alloc(mm, pgd, address);        /* 分配 P4D(第二级) */
    vmf.pud = pud_alloc(mm, p4d, address);    /* 分配 PUD(第三级) */
    vmf.pmd = pmd_alloc(mm, vmf.pud, address); /* 分配 PMD(第四级) */

    /* 2. 尝试分配透明大页(PUD 级别,1GB 大页) */
    if (pud_none(*vmf.pud) && __transparent_hugepage_enabled(vma)) {
        ret = create_huge_pud(&vmf);
        if (!(ret & VM_FAULT_FALLBACK))
            return ret;
    }

    /* 3. 尝试分配透明大页(PMD 级别,2MB 大页) */
    if (pmd_none(*vmf.pmd) && __transparent_hugepage_enabled(vma)) {
        ret = create_huge_pmd(&vmf);
        if (!(ret & VM_FAULT_FALLBACK))
            return ret;
    }

    /* 4. 普通 4KB 页的缺页处理 */
    return handle_pte_fault(&vmf);
}
页表分配的惰性特点:p4d_alloc()、pud_alloc()、pmd_alloc() 都是"如果不存在则分配"。这意味着页表本身也是按需分配的——只有当进程真正访问某个区域时,才会为该区域分配各级页表页。这节省了内核内存,因为一个进程的虚拟地址空间很大,但实际使用的区域有限。
2.6.4 匿名页缺页:do_anonymous_page()
当进程第一次访问匿名映射(如堆、栈的新页)时,触发匿名页缺页:
static vm_fault_t do_anonymous_page(struct vm_fault *vmf)
{
    struct vm_area_struct *vma = vmf->vma;
    struct page *page;
    pte_t entry;

    /* 共享匿名映射由 tmpfs/shmem 负责,走到这里属于异常 */
    if (vma->vm_flags & VM_SHARED)
        return VM_FAULT_SIGBUS;

    /* 按需分配最后一级页表页 */
    if (pte_alloc(vma->vm_mm, vmf->pmd))
        return VM_FAULT_OOM;

    /* 读故障:不分配物理页,映射到全局只读零页 ZERO_PAGE */
    if (!(vmf->flags & FAULT_FLAG_WRITE) &&
        !mm_forbids_zeropage(vma->vm_mm)) {
        entry = pte_mkspecial(pfn_pte(my_zero_pfn(vmf->address),
                                     vma->vm_page_prot));
        /* 加锁后 set_pte_at 写入页表即返回;将来写入时再触发写保护缺页 */
        return 0;
    }

    /* 写故障:分配一个真正的、已清零的物理页 */
    anon_vma_prepare(vma);
    page = alloc_zeroed_user_highpage_movable(vma, vmf->address);
    __SetPageUptodate(page);

    /* 计入 memcg、建立反向映射、加入 LRU */
    mem_cgroup_charge(page, vma->vm_mm, GFP_KERNEL);
    page_add_new_anon_rmap(page, vma, vmf->address, false);
    lru_cache_add_inactive_or_unevictable(page, vma);

    /* 构造 PTE;VMA 可写则同时置写位和脏位 */
    entry = mk_pte(page, vma->vm_page_prot);
    entry = pte_sw_mkyoung(entry);
    if (vma->vm_flags & VM_WRITE)
        entry = pte_mkwrite(pte_mkdirty(entry));
    set_pte_at(vma->vm_mm, vmf->address, vmf->pte, entry);
}
零页(Zero Page)优化:这里按读、写故障分两条路。读故障(例如进程申请内存后先读取)不分配物理页,而是把 PTE 映射到全局共享的只读零页,等真正写入时再经写保护缺页分配独立页;写故障(例如栈增长、申请后立即写)则直接分配一个清零页。于是进程即使预留了很大的匿名空间,不写入就几乎不占用物理内存。
2.6.5 写时复制(COW):wp_page_copy()
当多个进程共享一个只读页(如 fork 后的代码段、共享库),其中一个进程尝试写入时,触发写保护缺页,内核执行 COW:
static vm_fault_t wp_page_copy(struct vm_fault *vmf)
{
    struct vm_area_struct *vma = vmf->vma;
    struct page *old_page = vmf->page;  /* 原来的共享只读页 */
    struct page *new_page;

    /* 1. 分配新页 */
    new_page = alloc_page_vma(GFP_HIGHUSER_MOVABLE, vma, vmf->address);

    /* 2. 复制旧页内容到新页 */
    copy_user_highpage(new_page, old_page, vmf->address, vma);

    /* 3. 删除旧页的映射,建立新页的可写映射 */
    do_wp_page(vmf, old_page, new_page);
    /* 内部:flush_icache_page、set_pte_at 新页的可写 PTE、
       更新旧页的 mapcount 和 LRU 状态 */
}
COW 的完整场景:
fork()时,子进程的页表被设置为与父进程相同,且所有页标记为只读。父子进程共享物理页,
page->_mapcount增加(表示有多个 PTE 映射该页)。当父或子进程写入某页时,触发写保护缺页。
内核检查
page->_mapcount,如果大于 0(有多个映射),则执行 COW:分配新页、复制内容、替换页表映射。如果
_mapcount为 0(只有一个映射),说明该页已经是私有的,直接将 PTE 改为可写即可,无需复制。
2.6.6 文件映射缺页:do_fault()
对于文件映射的 VMA(如 mmap 一个文件),缺页时需要从文件读取数据:
static vm_fault_t do_fault(struct vm_fault *vmf)
{
    struct vm_area_struct *vma = vmf->vma;
    const struct vm_operations_struct *vma_ops = vma->vm_ops;

    if (!vma->vm_file) {
        /* 匿名映射但走了文件路径?不应该发生 */
        return VM_FAULT_SIGBUS;
    }

    if (vma->vm_flags & VM_SHARED) {
        /* 共享映射:直接调用文件系统的 fault 方法 */
        return vma_ops->fault(vmf);
    }

    /* 私有映射(MAP_PRIVATE):先读入页,后续写入时 COW */
    if (vmf->flags & FAULT_FLAG_WRITE) {
        /* 写缺页:先读入,然后 COW */
        ret = do_cow_fault(vmf);
    } else {
        /* 读缺页:直接读入 */
        ret = do_read_fault(vmf);
    }
}
文件系统的 fault 方法(如 ext4 的 ext4_filemap_fault)最终会调用 filemap_fault(),从 page cache 查找页,未命中则从磁盘读取。
2.7 页面回收与 OOM
2.7.1 原理:为什么需要页面回收
物理内存是有限的,而进程的虚拟地址空间可以远大于物理内存。当物理内存不足时,内核需要回收一些不常用的页,为新的分配腾出空间。
可回收的页:
文件页(Page Cache):页缓存中的页,内容有磁盘备份。干净页(未修改)可以直接丢弃;脏页(已修改)需要先写回磁盘再回收。
匿名页:用户进程的堆、栈等,没有磁盘备份。需要写入 swap 分区/文件后才能回收。
不可回收页:内核代码、内核数据结构、锁定的页(mlock)等,不能回收。
2.7.2 LRU 链表机制
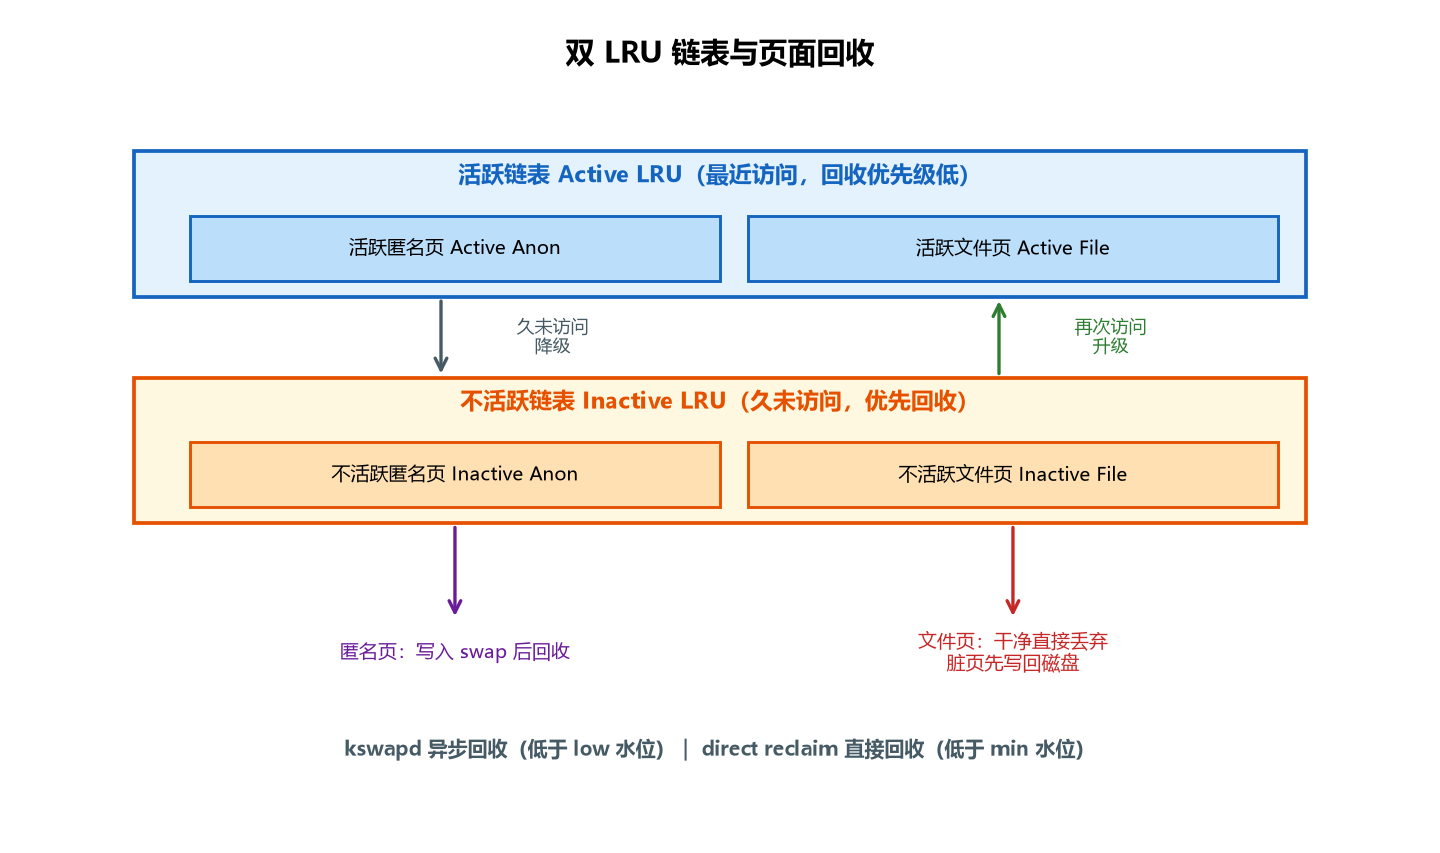
Linux 使用双 LRU 链表(活跃/不活跃 × 匿名/文件,共 4 个链表)来管理可回收页:
┌─────────────────────────────────────────────────────┐
│                    活跃链表 (active)                    │
│  最近被访问过的页,回收优先级低                          │
│  ┌──────────────┐  ┌──────────────┐                  │
│  │ 活跃匿名页     │  │ 活跃文件页     │                  │
│  └──────────────┘  └──────────────┘                  │
└─────────────────────────────────────────────────────┘
         │ 页一段时间未被访问         │
         ▼                            ▼
┌─────────────────────────────────────────────────────┐
│                   不活跃链表 (inactive)                 │
│  一段时间未被访问的页,回收优先级高                       │
│  ┌──────────────┐  ┌──────────────┐                  │
│  │ 不活跃匿名页   │  │ 不活跃文件页   │                  │
│  └──────────────┘  └──────────────┘                  │
└─────────────────────────────────────────────────────┘
         │                            │
         ▼ 写入 swap                  ▼ 直接丢弃/写回
      回收                         回收
页面在 LRU 之间的迁移:
新分配的页加入不活跃链表头部。
页被访问时,设置
PG_referenced标志。当不活跃链表的页被再次访问(
PG_referenced已置位),迁移到活跃链表。活跃链表的页在定期扫描中如果未被访问,清除
PG_referenced;再次扫描仍未访问则迁移到不活跃链表。回收时从不活跃链表尾部开始(最久未访问的页)。
这是经典的第二次机会算法(Second Chance)的改进版,结合了 LRU 的思想。
2.7.3 回收的触发方式
kswapd内核线程:当某个 zone 的空闲页低于WMARK_LOW时,唤醒kswapd异步回收内存,直到空闲页恢复到WMARK_HIGH。这是"温和"的回收,不阻塞进程。直接回收(Direct Reclaim):当分配请求快速路径失败,且
kswapd来不及回收时,分配进程自己进入回收路径,同步回收内存。这会阻塞进程,增加分配延迟。内存规整(Compaction):系统长期运行后,空闲页分散在物理地址各处(外部碎片),空闲总量虽够,却凑不出大块物理连续内存。规整把 zone 前部的可移动页迁移到后部,把空闲页腾挪集中到一起,从而凑出大块连续区,过程不丢数据。它既可以由
kcompactd内核线程异步进行,也可以在分配路径上同步触发;分配 2MB 透明大页是最常见的触发场景(见Documentation/admin-guide/mm/concepts.rst)。
2.7.4 OOM Killer
当内存严重不足,回收和压缩都无法满足分配时,内核触发 OOM(Out Of Memory)杀手,选择一个进程杀死以释放内存。
选择算法 oom_badness()(mm/oom_kill.c):
给每个进程打分,分数越高越可能被杀死。
主要考虑因素:进程占用的内存(RSS + swap)、进程的
oom_score_adj调整值、是否是内核线程(不杀)、是否是 init 进程(不杀)。/proc/<pid>/oom_score_adj可以手动调整,范围 -1000(永不被杀)到 1000(优先被杀)。OOM 日志会打印被选中进程的内存使用信息,帮助调试。
2.8 大页:HugeTLB 与透明大页(THP)
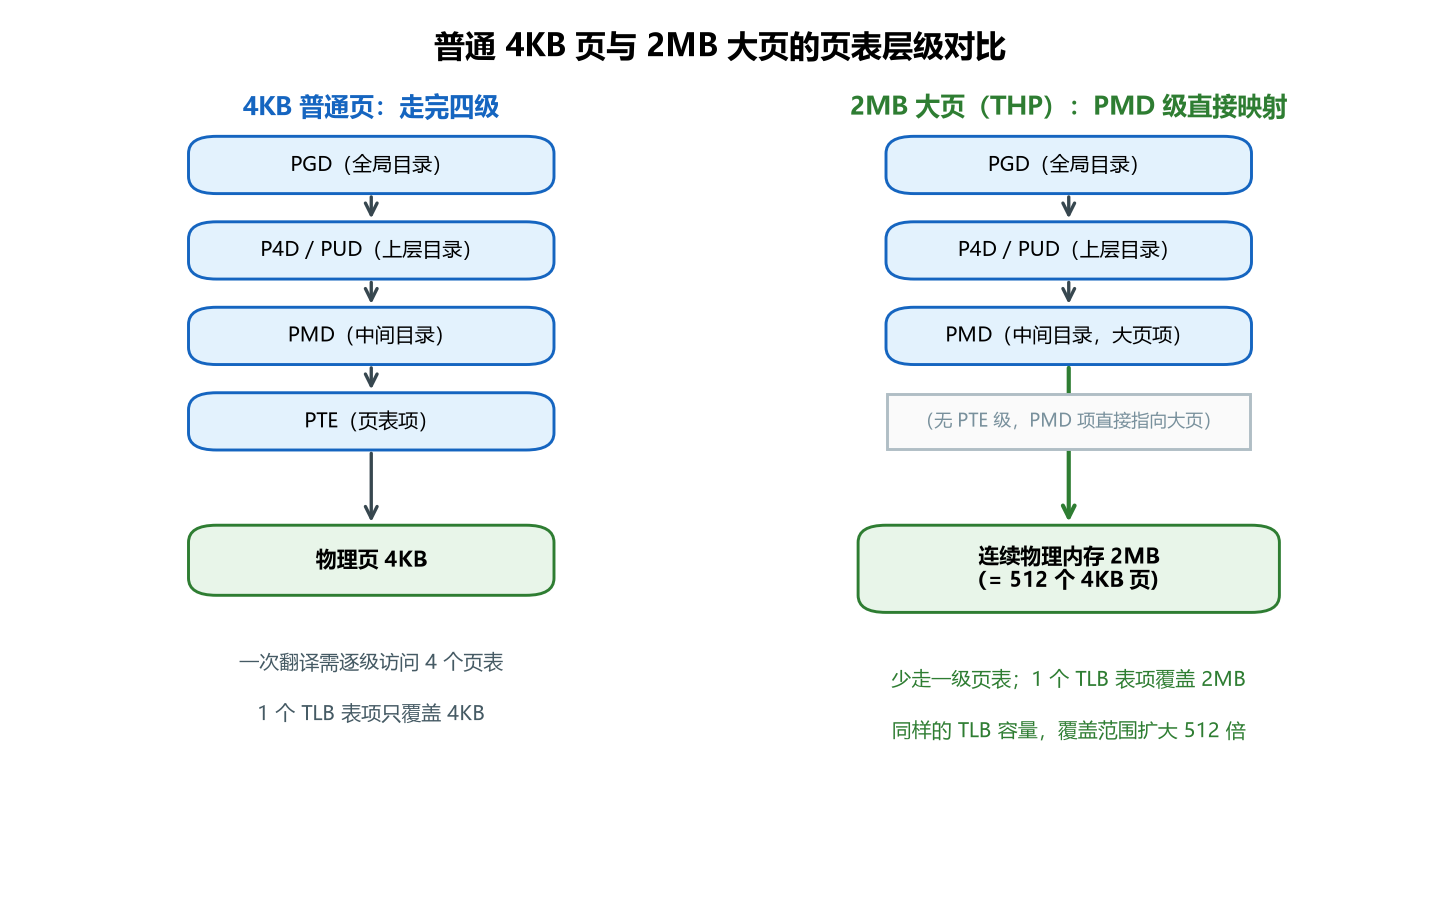
为什么需要大页:多级页表的每次地址翻译都要访问多次内存,CPU 用 TLB(Translation Lookaside Buffer,转译后备缓冲器)缓存"虚拟页→物理页"的翻译结果。TLB 容量很小,程序的内存工作集一大,4KB 小页就会让 TLB 表项不够用、频繁失效(TLB miss),每次失效都要逐级走页表,开销可观。改用更大的页,一个 TLB 表项就能覆盖更大的地址范围,命中率随之提高。x86-64 支持 2MB(在 PMD 级直接映射、少走一级页表)和 1GB(PUD 级)两种大页。
Linux 提供两套大页机制(见 Documentation/admin-guide/mm/concepts.rst 与 transhuge.rst):
HugeTLB(hugetlbfs):显式机制。管理员预先预留固定数量的大页(
/proc/sys/vm/nr_hugepages),应用通过映射 hugetlbfs 文件或SHM_HUGETLB显式使用。这些大页被单独管理、不能换出,行为确定,数据库等对延迟敏感的程序常用。透明大页 THP(Transparent HugePages):对应用透明,内核尽量用 2MB 大页映射匿名内存,程序无需改造。它有两条产生路径:缺页时若能当场凑出连续 2MB,就直接分配大页;平时由
khugepaged内核线程低频扫描,把已经分散映射的一串 4KB 页"坍缩"(collapse)成一个大页。
THP 的总开关在 /sys/kernel/mm/transparent_hugepage/enabled,有三态:
always:对所有匿名内存尽量使用大页。madvise(常见默认):只对用madvise(MADV_HUGEPAGE)显式标记的区域使用大页。never:关闭。
配套的 defrag 控制"为了凑出大页愿意付出多大代价"(是否做直接回收和规整),取值有 always/defer+madvise/madvise/never。凑一个 2MB 大页需要物理上连续的 512 个 4KB 页,这正是 2.7.3 内存规整主要服务的场景;一时凑不出来时,内核先用普通 4KB 页顶着,等 khugepaged 之后再坍缩。
代价:大页以 2MB 为最小粒度,只用少量数据也占一整页,可能降低内存有效利用率;坍缩和规整要搬运页面、消耗 CPU。因此 THP 对连续大块、长期运行的负载(数据库、JVM、虚拟机)收益明显,对大量小而短命分配的负载反而可能带来延迟毛刺,这也是不少生产系统把 THP 设为 madvise 的原因。
2.9 内存管理子系统总结
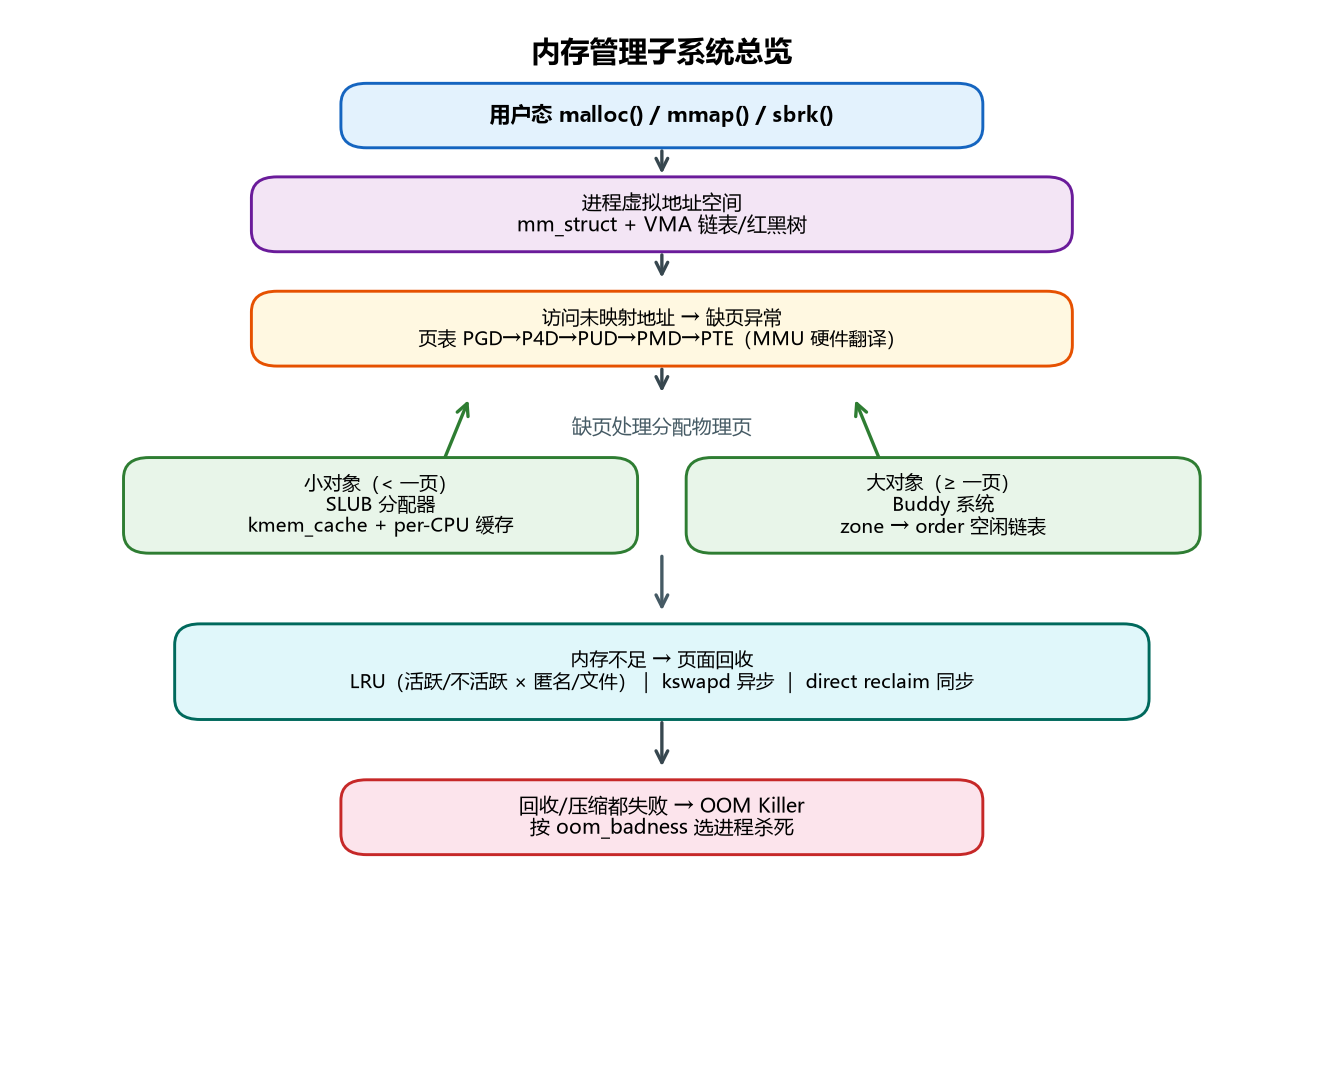
用户态 malloc()/mmap()/sbrk()
        │
        ▼  虚拟地址空间操作(VMA 增删改)
进程地址空间(mm_struct + VMA 链表/红黑树)
        │
        ▼  访问未映射地址 → 缺页异常
页表映射(PGD→P4D→PUD→PMD→PTE,MMU 硬件翻译)
        │
        ▼  缺页处理分配物理页
物理内存分配
  ├─ 小对象(<页)→ SLUB 分配器(kmem_cache,per-CPU 缓存)
  └─ 大对象(≥页)→ Buddy 系统(zone → order 空闲链表,分裂/合并)
        │
        ▼  内存不足
页面回收(LRU 活跃/不活跃 × 匿名/文件)
  ├─ kswapd 异步回收(水位低于 low)
  ├─ direct reclaim 直接回收(分配路径中)
  └─ 都失败 → OOM Killer 杀死进程
本章要点:
分层抽象:虚拟地址空间 → 页表 → 物理页 → 小对象,每一层解决不同的问题。
按需分配:页表、物理页、匿名页都是按需分配,不访问不占用资源。
懒惰与 COW:能不复制就不复制(fork COW、零页共享),能推迟就推迟(write-back、惰性页表分配)。
缓存与批处理:SLUB per-CPU 缓存、Buddy pcp 缓存、Page Cache,减少锁竞争和慢速操作。
水位线与阈值:zone 水位线控制回收时机,budget 控制回收力度,保证系统稳定。
DISCUSSION
评论