WRITING
第六章 网络子系统
第六章 网络子系统
6.1 操作系统原理:网络协议栈的本质
6.1.1 为什么需要协议栈
计算机网络的核心问题是:如何在不可靠的物理媒介(以太网、WiFi、光纤)上实现可靠、高效、有序的数据传输。问题本身比较复杂,因此网络协议采用分层设计,每一层负责特定的功能,通过接口与上下层交互。
OSI 七层模型 vs TCP/IP 四层模型:
OSI 七层 | TCP/IP 四层 | 典型协议 | Linux 实现位置 |
|---|---|---|---|
应用层 | 应用层 | HTTP/FTP/SSH | 用户态应用 |
表示层 | TLS/SSL | 用户态库 | |
会话层 | RPC | 用户态库 | |
传输层 | 传输层 | TCP/UDP/SCTP/DCCP |
|
网络层 | 网络层 | IP/ICMP/ARP |
|
数据链路层 | 网络接口层 | Ethernet/VLAN |
|
物理层 | 以太网/WiFi/光纤 | 网卡硬件 + 驱动 |
Linux 内核实现了从网络接口层(链路层)到传输层的完整协议栈,应用层协议由用户态实现。
6.1.2 分层的好处
模块化:每层独立实现,可以单独修改和优化(如更换拥塞控制算法不影响 IP 层)。
复用性:上层协议可以复用下层服务(TCP 和 UDP 都使用 IP,IP 可以运行在以太网、WiFi、PPP 等多种链路层之上)。
可测试性:每层可以独立测试和调试。
互操作性:不同厂商的实现只要遵循相同的协议接口,就可以互通。
6.1.3 套接字(Socket)抽象
**Socket(套接字)**是操作系统为应用程序提供的网络编程接口,是应用层与内核协议栈之间的桥梁。Socket 抽象了不同协议族(IPv4/IPv6/Unix域)和不同套接字类型(流/TCP、数据报/UDP、原始)的差异,为应用提供统一的接口。
Socket 的核心操作:
socket():创建套接字,指定协议族(AF_INET/AF_INET6/AF_UNIX)、类型(SOCK_STREAM/SOCK_DGRAM/SOCK_RAW)、协议。bind():绑定本地地址和端口。listen():标记为被动套接字,开始监听连接请求,创建半连接队列和全连接队列。accept():从全连接队列取出已完成三次握手的连接,返回新的套接字。connect():主动发起连接(TCP 三次握手)。send()/recv():发送/接收数据。close():关闭套接字(TCP 四次挥手)。
Socket 的内核结构:struct socket 是 VFS 层的抽象(socket 也是一种文件,有文件描述符),struct sock(简称 sk)是协议层的抽象,包含协议特定的状态和缓冲区。
6.2 Linux 网络栈全景
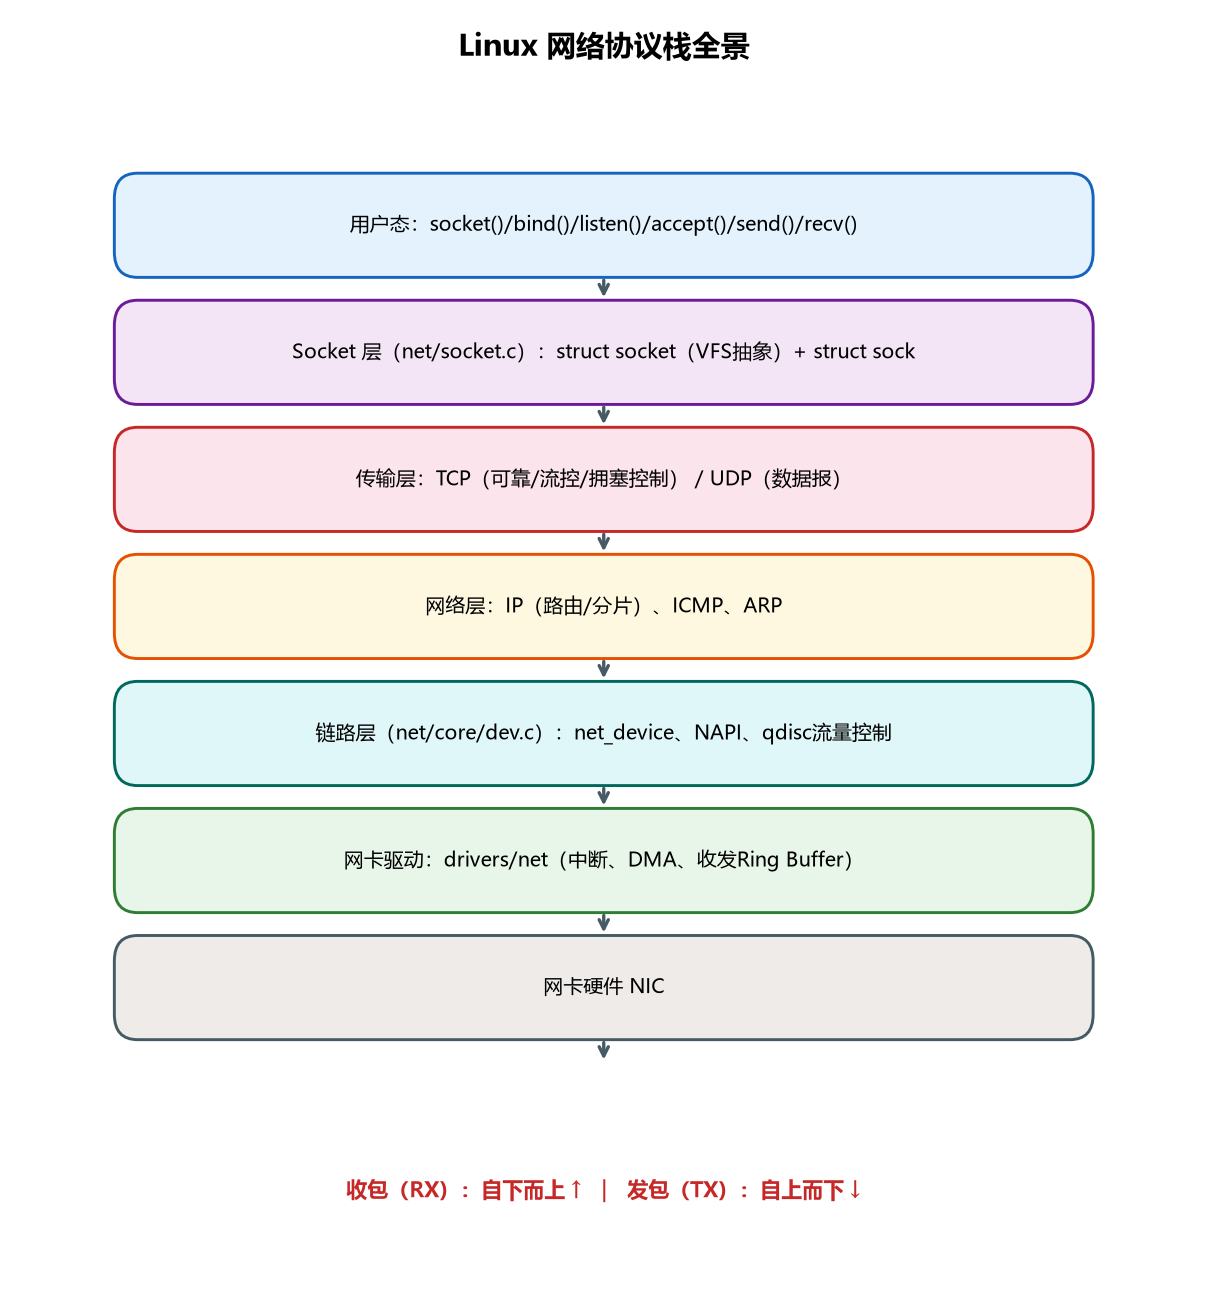
┌─────────────────────────────────────────────────────────────┐
│                       用户态应用程序                            │
│         socket()/bind()/listen()/accept()/connect()           │
│              send()/recv()/read()/write()                     │
├─────────────────────────────────────────────────────────────┤
│                  系统调用接口(SCI)                              │
├─────────────────────────────────────────────────────────────┤
│  Socket 层(net/socket.c)                                      │
│  struct socket(VFS 抽象)+ struct sock(协议抽象)             │
│  套接字创建、绑定、监听、连接、收发、关闭                         │
├─────────────────────────────────────────────────────────────┤
│  传输层(net/ipv4/tcp.c, udp.c, ...)                          │
│  TCP:连接管理、流量控制、拥塞控制、可靠传输、重传               │
│  UDP:无连接数据报、校验和                                       │
│  发送缓冲区 / 接收缓冲区(sk->sk_send_head / sk_receive_queue) │
├─────────────────────────────────────────────────────────────┤
│  网络层(net/ipv4/ip_input.c, ip_output.c, ip_forward.c)     │
│  IP:路由查找、分片与重组、TTL、校验和                           │
│  ICMP:差错报告与查询(ping/traceroute)                        │
│  ARP:IP 地址到 MAC 地址的解析(net/ipv4/arp.c)               │
├─────────────────────────────────────────────────────────────┤
│  链路层(net/core/dev.c, net/ethernet/eth.c)                  │
│  设备无关层:net_device 抽象、NAPI、流量控制(qdisc)、          │
│  VLAN、桥接、发包(dev_queue_xmit)、收包(netif_rx/napi_gro_receive)│
├─────────────────────────────────────────────────────────────┤
│  驱动层(drivers/net/ethernet/, drivers/net/wireless/, ...)   │
│  网卡驱动:初始化、中断处理、DMA、发送队列、接收队列              │
├─────────────────────────────────────────────────────────────┤
│                       网卡硬件(NIC)                             │
│         以太网控制器 / WiFi 芯片 / 光纤网卡                       │
└─────────────────────────────────────────────────────────────┘
6.3 核心数据结构:struct sk_buff 详解
6.3.1 sk_buff 的设计思想
**struct sk_buff(socket buffer,简称 skb)**是 Linux 网络栈中最重要的数据结构,代表一个网络数据包。它贯穿整个协议栈,从驱动收包到应用层接收,从应用层发送到驱动发包,都使用 skb 表示数据包。
skb 的设计需要满足以下要求:
分层协议头的高效处理:数据包在协议栈中逐层传递,每层添加/移除自己的协议头。skb 需要支持高效地在数据区前后添加/移除头部,无需数据拷贝。
分散/聚集(Scatter-Gather):数据包的数据可能分散在多个内存页中(如用户态缓冲区、页缓存),skb 需要支持分散内存的引用,无需拷贝到连续缓冲区。
零拷贝(Zero-Copy):在可能的情况下,数据包数据在协议栈传递过程中不拷贝,只传递指针和元数据。
克隆(Clone):同一个数据包可能需要发送给多个接收者(如多播、tcp 备份、流量控制),skb 支持克隆元数据但共享数据区。
高效内存管理:网络数据包数量巨大,skb 的分配和释放需要高效,使用专门的缓存(kmem_cache)和每 CPU 缓存。
6.3.2 sk_buff 结构详解
源码位置:include/linux/skbuff.h
struct sk_buff {
    /* 链表节点:用于将 skb 链接到各种队列(接收队列、发送队列等) */
    union {
        struct {
            struct sk_buff *next;     /* 链表下一个 */
            struct sk_buff *prev;     /* 链表上一个 */
            union {
                struct net_device *dev;  /* 接收/发送的网络设备 */
                unsigned long dev_scratch; /* 驱动私有临时数据 */
            };
        };
        struct rb_node rbnode;        /* 红黑树节点(用于 TCP 重组、netem 等) */
        struct list_head list;         /* 通用链表节点 */
    };

    struct sock *sk;                   /* 关联的 socket(传输层) */

    ktime_t tstamp;                    /* 时间戳(收包时间/发包时间) */

    /* 控制缓冲区:48 字节,各层私有数据,跨层需 clone 才能保留 */
    char cb[48] __aligned(8);

    /* 路由缓存和析构函数 */
    union {
        struct {
            unsigned long _skb_refdst;  /* 路由缓存(dst_entry) */
            void (*destructor)(struct sk_buff *skb);  /* 析构函数 */
        };
        struct list_head tcp_tsorted_anchor;  /* TCP 时间排序锚点 */
    };

    /* 长度信息 */
    unsigned int len,                   /* 总长度(协议头 + 数据,线性区 + 分片) */
                 data_len;              /* 分片数据长度(非线性区数据长度) */
    __u16 mac_len,                      /* MAC 头长度 */
          hdr_len;                      /* 已写协议头长度(克隆时使用) */

    __u16 queue_mapping;                /* 发送队列映射(多队列网卡) */

    /* 标志位 */
    __u8 cloned:1,                      /* 是否是克隆 */
         nohdr:1,                       /* 不分配头部空间 */
         fclone:2,                      /* fast clone 状态 */
         peeked:1,                      /* 被 peek 过(MSG_PEEK) */
         head_frag:1,                   /* 线性区是 frag(分片) */
         pfmemalloc:1,                  /* 来自内存预留分配(回收上下文) */
         pp_recycle:1;                  /* page_pool 回收标记 */

    /* 协议头偏移(相对于 head) */
    sk_buff_data_t transport_header;    /* 传输层头偏移(TCP/UDP 头) */
    sk_buff_data_t network_header;      /* 网络层头偏移(IP 头) */
    sk_buff_data_t mac_header;          /* MAC 层头偏移(以太网头) */

    /* 数据指针 */
    sk_buff_data_t tail;                /* 数据末尾偏移 */
    sk_buff_data_t end;                 /* 线性缓冲区末尾偏移 */
    unsigned char *head;                /* 线性缓冲区起始地址 */
    unsigned char *data;                /* 当前数据起始地址(随协议层移动) */
    unsigned int truesize;              /* skb 总大小(结构体内存 + 数据缓冲区) */
    atomic_t users;                     /* 引用计数 */

    /* 分片列表(非线性区数据,分散在多个内存页中) */
    skb_frag_t frags[MAX_SKB_FRAGS];    /* 分片数组(默认 17 个) */
    /* ... */
};
6.3.3 数据区与协议头操作
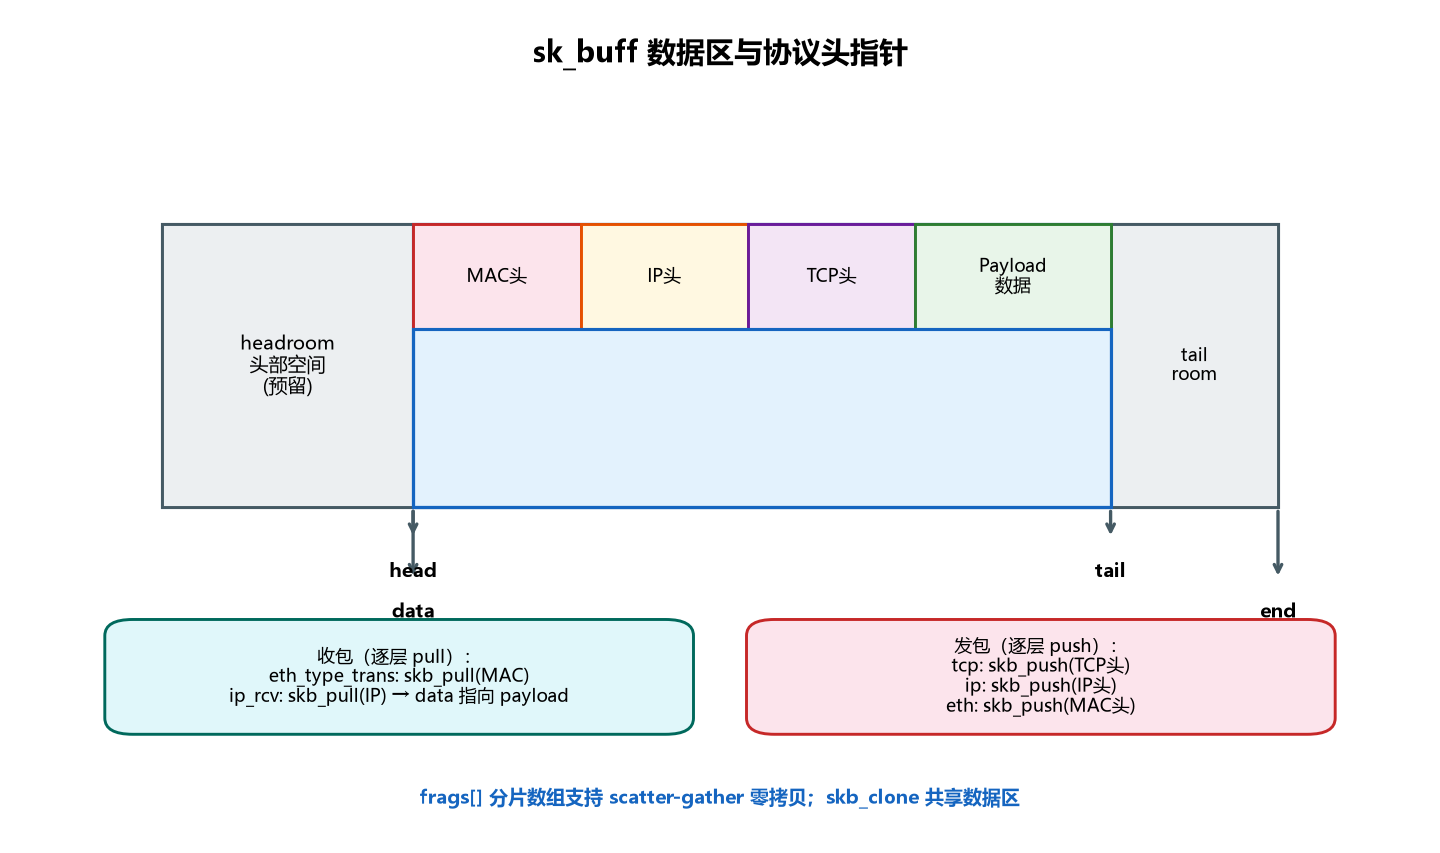
skb 的数据区布局:
低地址                                                          高地址
┌───────────────────────────────────────────────────────────────┐
│  head                                                           │
│  │                                                              │
│  ├── 头部空间(headroom):用于添加协议头(发包时)            │
│  │                                                              │
│  ├── data:当前协议数据起始                                     │
│  │   │                                                          │
│  │   ├── MAC 头(14字节)                                      │
│  │   ├── IP 头(20字节)                                       │
│  │   ├── TCP 头(20字节)                                      │
│  │   └── 数据 payload                                           │
│  │                                                              │
│  ├── tail:数据末尾                                             │
│  │                                                              │
│  └── 尾部空间(tailroom):用于添加数据或尾部协议头            │
│                                                                  │
│  end:线性缓冲区末尾                                            │
└───────────────────────────────────────────────────────────────┘
关键操作函数:
函数 | 作用 | 典型场景 |
|---|---|---|
| 向下移动 tail,增加数据长度 | 向数据包末尾添加数据 |
| 向上移动 data,在头部添加协议头 | 发包时各层添加协议头 |
| 向下移动 data,移除协议头 | 收包时各层移除协议头 |
| 同时移动 data 和 tail,预留头部空间 | 新建 skb 时预留协议头空间 |
| 返回头部空间大小 | 检查是否有足够空间添加头部 |
| 返回尾部空间大小 | 检查是否有足够空间添加数据 |
| 克隆 skb(复制元数据,共享数据区) | 多播、流量复制 |
| 完全复制 skb(元数据 + 数据区) | 需要修改数据时 |
收包时的协议头移除过程:
驱动收到数据包:data 指向 MAC 头
  → eth_type_trans():skb_pull(skb, ETH_HLEN),data 指向 IP 头
  → ip_rcv():处理 IP 头,skb_pull(skb, ip_hdrlen),data 指向 TCP/UDP 头
  → tcp_v4_rcv()/udp_rcv():处理传输层头,data 指向 payload
  → 复制 payload 到用户态
发包时的协议头添加过程:
应用层发送数据:data 指向 payload
  → tcp_sendmsg()/udp_sendmsg():skb_push() 添加 TCP/UDP 头
  → ip_queue_xmit():skb_push() 添加 IP 头
  → dev_queue_xmit():skb_push() 添加以太网头
  → 驱动发送:data 指向 MAC 头,整个数据包发送到网卡
6.3.4 分片(frags)与 Scatter-Gather
skb 的数据分为两部分:
线性区(linear area):
head到end的连续内存缓冲区,data到tail是实际数据。非线性区(non-linear area / frags):
frags[]数组,每个元素是一个skb_frag_t,指向一个内存页中的一段数据。
len = (tail - data) + data_len,其中 data_len 是所有 frags 的数据长度之和。
为什么需要 frags?
发送大数据时,数据可能来自用户态缓冲区(分散在多个物理页)或页缓存,不需要拷贝到连续的线性区,直接通过 frags 引用这些页,实现零拷贝。
网卡支持 Scatter-Gather DMA(
NETIF_F_SG),可以直接从分散的内存页中读取数据发送,无需内核组装成连续缓冲区。
6.3.5 skb 的分配与释放
skb 使用专门的 kmem_cache 分配(skbuff_head_cache),数据缓冲区单独分配。常见的分配函数:
alloc_skb():分配 skb 和指定大小的线性数据缓冲区。netdev_alloc_skb():为网卡接收分配 skb,预留了足够的头部空间。dev_alloc_skb():netdev_alloc_skb()的别名。skb_clone():克隆 skb,共享数据区(引用计数)。
释放:kfree_skb() 减少引用计数,为 0 时释放 skb 和数据缓冲区。
6.4 收包路径(Receive Path)
6.4.1 收包全景
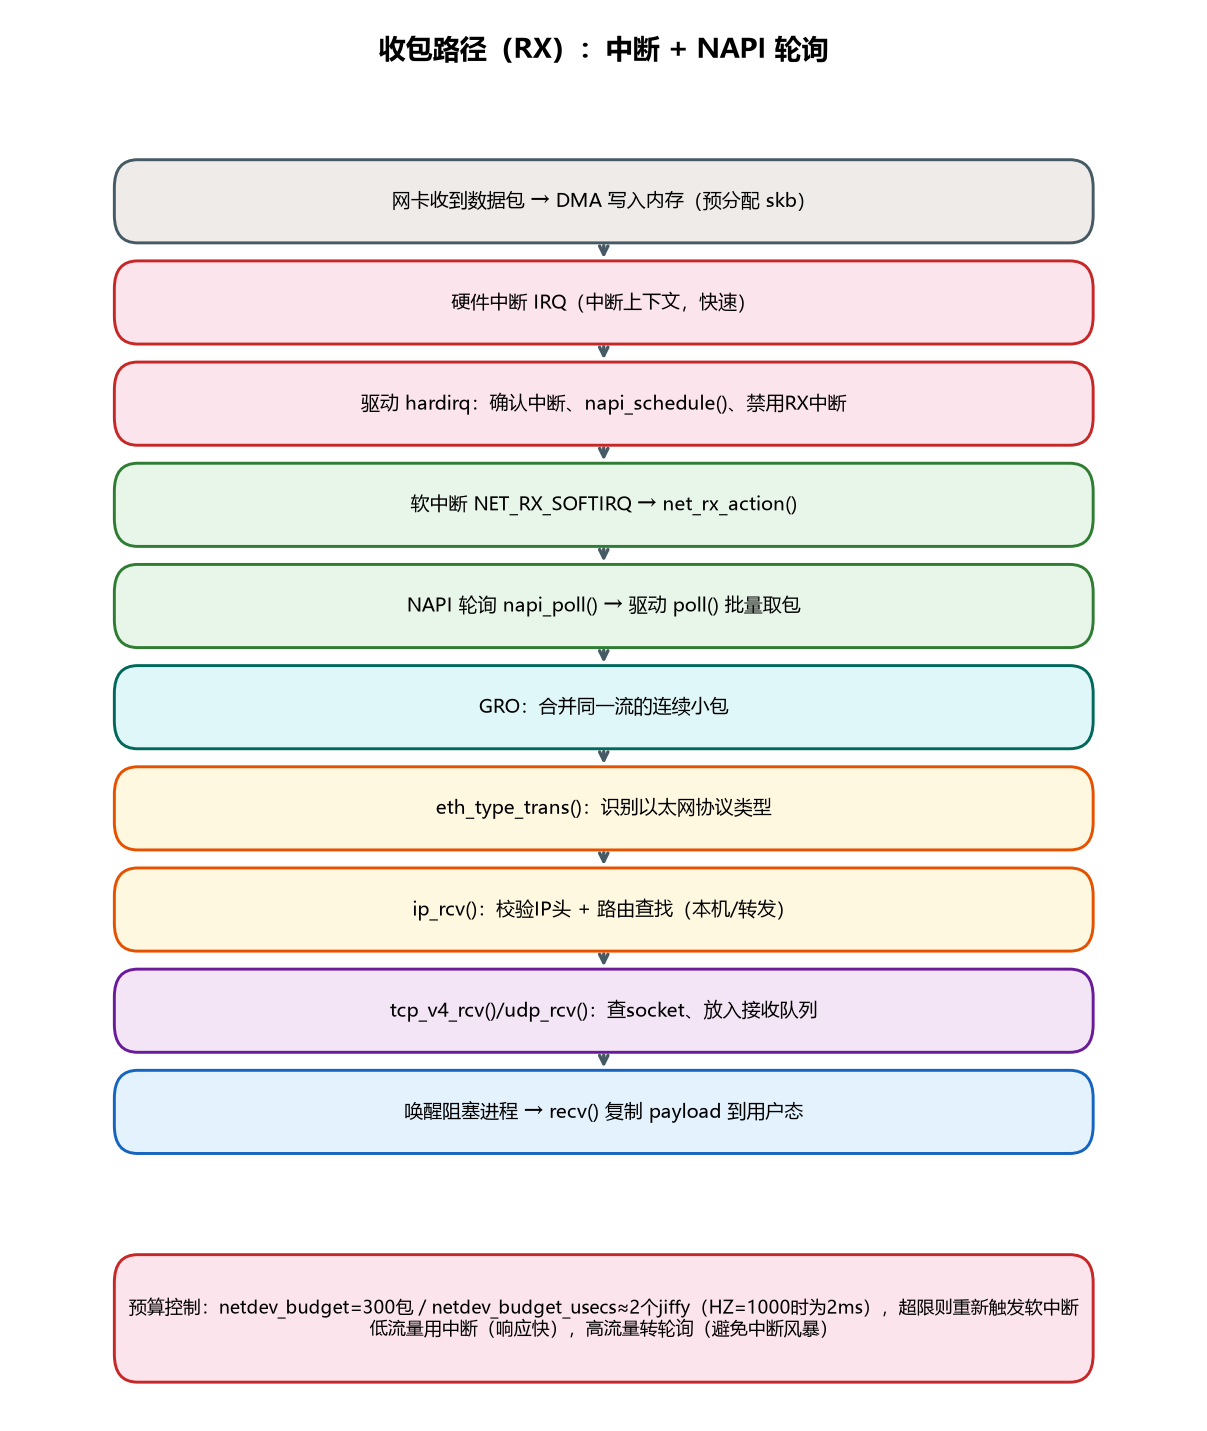
网卡收到数据包
  │
  ▼ DMA:网卡将数据包从网络复制到内存(驱动预先分配的 skb 缓冲区)
  │
  ▼ 硬件中断(IRQ):网卡触发中断通知 CPU
  │
  ▼ 驱动中断处理程序(Hard IRQ,中断上下文)
  │  1. 确认中断(清除中断状态寄存器)
  │  2. 禁用接收中断(避免中断风暴)
  │  3. 调用 napi_schedule() 调度 NAPI 软中断
  │  4. 快速返回(不处理数据包内容)
  │
  ▼ 软中断 NET_RX_SOFTIRQ → net_rx_action()(不可睡眠;常允许硬中断进入)
  │
  ▼ NAPI 轮询:napi_poll() → 驱动的 poll() 方法
  │  批量从网卡接收队列取包(最多 budget 个包或 2ms 时间)
  │  每个包调用 napi_gro_receive()
  │
  ▼ GRO(Generic Receive Offload):将多个小的 TCP 包合并为一个大包
  │  减少协议栈处理开销
  │
  ▼ 协议栈处理
  │  ├─ 链路层:eth_type_trans() 识别协议(IP/ARP/VLAN/PPPoE)
  │  ├─ 网络层:ip_rcv() → ip_rcv_finish() → 路由查找
  │  │     ├─ 本机包 → ip_local_deliver() → 传输层
  │  │     └─ 转发包 → ip_forward() → ip_output() → 发送路径
  │  ├─ 传输层:
  │  │     ├─ TCP → tcp_v4_rcv() → 查找 socket → 放入接收队列 → 唤醒进程
  │  │     └─ UDP → udp_rcv() → 查找 socket → 放入接收队列
  │  └─ 其他协议(ICMP/IGMP 等)
  │
  ▼ 应用层:recv()/read() 从 socket 接收队列复制数据到用户态缓冲区
6.4.2 NAPI 机制详解
**NAPI(New API)**是 Linux 网络收包的核心机制,解决了传统中断驱动收包在高流量下的"中断风暴"问题。
传统中断驱动的问题:
每个数据包到达都触发一次中断。
高流量下(如 10Gbps 网卡,每秒数百万包),中断数量巨大,CPU 大部分时间在处理中断,无法处理数据包(活锁,livelock)。
中断处理关中断,影响系统响应性。
NAPI 的解决方案:中断 + 轮询结合
低流量时:数据包到达触发中断,中断处理程序调度 NAPI 软中断,软中断中处理数据包。
高流量时:NAPI 进入轮询模式,持续从网卡取包而不响应接收中断,直到取完或达到预算。处理完后重新开启中断。
这样,高流量下中断数量大大减少(不是每个包一个中断,而是批量处理),CPU 可以高效处理数据包。
NAPI 的核心数据结构 struct napi_struct:
struct napi_struct {
    struct list_head poll_list;      /* 软中断的 poll 链表 */
    unsigned long state;             /* 状态(NAPI_STATE_SCHED 等) */
    int weight;                       /* 每次 poll 的最大包数(预算) */
    int (*poll)(struct napi_struct *, int);  /* 驱动的 poll 函数 */
    struct net_device *dev;          /* 所属网络设备 */
    struct list_head dev_list;       /* 设备的 NAPI 链表 */
    struct gro_list gro_hash[GRO_HASH_BUCKETS];  /* GRO 合并哈希表 */
    /* ... */
};
NAPI 的工作流程:
驱动初始化:调用
netif_napi_add()注册 NAPI,设置poll函数和weight(通常 64)。中断触发:数据包到达,网卡触发中断。
中断处理:驱动中断处理程序调用
napi_schedule():检查 NAPI 是否已经被调度(
NAPI_STATE_SCHED位)。如果没有,设置
NAPI_STATE_SCHED,将 NAPI 加入当前 CPU 的softnet_data.poll_list。触发
NET_RX_SOFTIRQ软中断。禁用网卡接收中断(
napi_disable或驱动自行禁用)。
软中断处理:
net_rx_action()遍历poll_list,调用每个 NAPI 的poll()函数:poll()从网卡接收队列批量取包,最多取weight个包。每个包调用
napi_gro_receive()送入协议栈。如果取到的包数等于
weight(说明还有更多包),NAPI 保持调度状态,继续轮询。如果取到的包数少于
weight(说明队列已空),调用napi_complete():清除
NAPI_STATE_SCHED。重新启用网卡接收中断。
预算控制:
net_rx_action()有全局预算(netdev_budget,默认 300 包)和时间限制(netdev_budget_usecs,等于 2 个 jiffy,即 2×10^6/HZ 微秒,HZ=1000 时为 2ms),超过则停止处理,剩余的留到下一次软中断。
6.4.3 net_rx_action() 详解
源码位置:net/core/dev.c
static __latent_entropy void net_rx_action(struct softirq_action *h)
{
    struct softnet_data *sd = this_cpu_ptr(&softnet_data);
    unsigned long time_limit = jiffies +
        usecs_to_jiffies(READ_ONCE(netdev_budget_usecs));  /* 时间限制:2 个 jiffy */
    int budget = READ_ONCE(netdev_budget);  /* 包数预算:300 */
    LIST_HEAD(list);
    LIST_HEAD(repoll);

    /* 1. 取出所有需要轮询的 NAPI */
    local_irq_disable();
    list_splice_init(&sd->poll_list, &list);
    local_irq_enable();

    /* 2. 遍历处理每个 NAPI */
    for (;;) {
        struct napi_struct *n;

        if (list_empty(&list)) {
            if (!sd_has_rps_ipi_waiting(sd) && list_empty(&repoll))
                return;  /* 全部处理完,返回 */
            break;
        }

        n = list_first_entry(&list, struct napi_struct, poll_list);
        budget -= napi_poll(n, &repoll);  /* 调用 NAPI poll 处理 */

        /* 3. 预算或时间用完,停止处理 */
        if (unlikely(budget <= 0 ||
                 time_after_eq(jiffies, time_limit))) {
            sd->time_squeeze++;  /* 记录预算紧张次数(网络拥塞指标) */
            break;
        }
    }

    /* 4. 将未处理完的 NAPI 重新加入 poll_list,再次触发软中断 */
    local_irq_disable();
    list_splice_tail_init(&sd->poll_list, &list);
    list_splice_tail(&repoll, &list);
    list_splice(&list, &sd->poll_list);
    if (!list_empty(&sd->poll_list))
        __raise_softirq_irqoff(NET_RX_SOFTIRQ);  /* 再次触发软中断 */
    local_irq_enable();
}
设计要点:
每 CPU
softnet_data:每个 CPU 有独立的softnet_data,包含poll_list(待处理的 NAPI 链表)、backlog(非 NAPI 驱动的收包队列)、统计信息等。避免全局锁竞争。预算控制:
netdev_budget(默认 300 包)和netdev_budget_usecs(默认 2 个 jiffy,HZ=1000 时为 2000μs)限制了每次软中断的处理量,避免网络软中断长时间占用 CPU(导致其他进程饥饿)。repoll 机制:如果 NAPI 的
poll()取到了weight个包(说明还有更多包),将其加入repoll列表,本轮结束后重新触发软中断继续处理。这实现了轮询模式的持续处理。time_squeeze是网络拥塞的重要指标:如果频繁出现预算用完,说明 CPU 处理不过来,可能需要增加 CPU、优化协议栈或限制流量。
6.4.4 GRO(Generic Receive Offload)
GRO是一种收包优化技术,将多个小的 TCP 包(通常是同一个流的连续数据包)合并为一个大包再送入协议栈,减少协议栈处理开销(每个包都要遍历协议栈、查找路由、查找 socket,合并后只处理一次)。
GRO 在 napi_gro_receive() 中实现:
根据数据包的五元组(源IP/目的IP/源端口/目的端口/协议)计算哈希。
在 GRO 哈希表中查找是否有匹配的、正在合并的大包。
如果匹配且数据包连续(序列号连续)、标志兼容,则将小包的数据合并到大包中(更新长度、序列号,将小包的 frags 挂到大包上)。
如果不匹配或不能合并(如 FIN/RST 包、乱序包),则将之前合并的大包 flush 到协议栈,开始新的合并。
NAPI poll 结束时,将所有未 flush 的合并包 flush 到协议栈。
GRO 是网卡 TSO(TCP Segmentation Offload,发送时大包分片由硬件完成)的收包对应物。现代网卡也支持 LRO(Large Receive Offload,硬件合并),但 LRO 对协议有侵入性(可能修改 IP/TCP 头),GRO 更通用和安全。
把这一族"分段/合并/校验"技术放在一起对比(见 Documentation/networking/segmentation-offloads.rst、checksum-offloads.rst):
TSO/GSO(发送侧分段):协议栈尽量构造大段,把切成 MSS 的工作推迟到最后。TSO 交给网卡硬件切;GSO(Generic Segmentation Offload)在网卡不支持时由软件在递交驱动前一刻才切,使协议栈上层始终按大包处理。
GRO/LRO(接收侧合并):把同一条流连续到达的小段合并成大段再上交协议栈,GRO 在软件层、LRO 在硬件层。
校验和卸载:IP/TCP/UDP 校验和的计算(发送)与验证(接收)尽量交给网卡,skb 用
ip_summed等字段记录状态,省去软件逐字节求和。
它们的共同思路是"能合并就合并、能推迟就推迟、能交给硬件就交给硬件",把协议栈遍历和内存拷贝的次数压到最少。
6.4.5 协议栈处理:从链路层到传输层
链路层:eth_type_trans():
识别以太网帧的协议类型(
ETH_P_IP/ETH_P_ARP/ETH_P_8021QVLAN/ETH_P_PPP_SES等)。设置 skb 的
protocol字段。调用
netif_receive_skb()送入协议栈。
网络层:ip_rcv() → ip_rcv_finish():
验证 IP 头(版本、长度、校验和、TTL)。
处理 IP 选项。
路由查找:
ip_route_input_noref()查找路由表,确定数据包是本机包还是转发包。本机包:调用
ip_local_deliver()→ip_local_deliver_finish()→ 根据协议号(IPPROTO_TCP/UDP/ICMP)分发到传输层。转发包:调用
ip_forward()→ 检查转发权限、TTL 减 1、分片 →ip_output()→ 发送路径。
传输层:TCP tcp_v4_rcv():
验证 TCP 头(校验和、长度)。
查找 socket:根据四元组(源IP/目的IP/源端口/目的端口)在 TCP 哈希表(
tcp_hashinfo)中查找。查找已建立连接的 socket(
ehash,established hash)。如果没找到,查找监听 socket(
listening_hash,listen hash),处理 SYN 包。
处理 TCP 状态机:根据 TCP 状态(LISTEN/SYN_SENT/ESTABLISHED/FIN_WAIT 等)和标志位(SYN/ACK/FIN/RST/PSH)执行相应处理。
数据处理:
放入 socket 的接收队列(
sk_receive_queue)或预接收队列(prequeue)。处理乱序包(放入乱序队列
out_of_order_queue,等缺失包到达后按序重组)。发送 ACK。
唤醒阻塞在
recv()上的进程(sk->sk_data_ready回调)。
UDP udp_rcv():
验证 UDP 头(校验和、长度)。
查找 socket:根据目的端口(和源端口/源IP)在 UDP 哈希表中查找。
将数据包放入 socket 的接收队列(
sk_receive_queue)。唤醒阻塞的进程。
如果没有找到 socket,发送 ICMP 端口不可达(除非设置了忽略)。
6.4.6 应用层接收:recv()
应用层 recv(fd, buf, count, flags)
  │
  ▼
sys_recvfrom() → sock_recvmsg() → inet_recvmsg()
  │
  ▼
tcp_recvmsg() / udp_recvmsg()
  │
  ├─ 1. 检查接收队列是否有数据
  │     - 有数据 → 直接复制
  │     - 无数据 → 阻塞等待(除非 MSG_DONTWAIT)
  │
  ├─ 2. 从接收队列取出 skb
  │
  ├─ 3. 将 skb 的 payload 复制到用户态缓冲区(copy_to_iter)
  │     - 支持 MSG_PEEK(偷看,不消耗数据)
  │     - 支持 MSG_WAITALL(等待直到填满缓冲区)
  │
  ├─ 4. 更新 socket 的接收窗口(TCP:根据已接收数据量调整接收窗口,发送窗口更新)
  │
  ├─ 5. 释放 skb(kfree_skb)
  │
  └─ 6. 返回复制的字节数
6.4.7 多核扩展:RSS / RPS / RFS / XPS
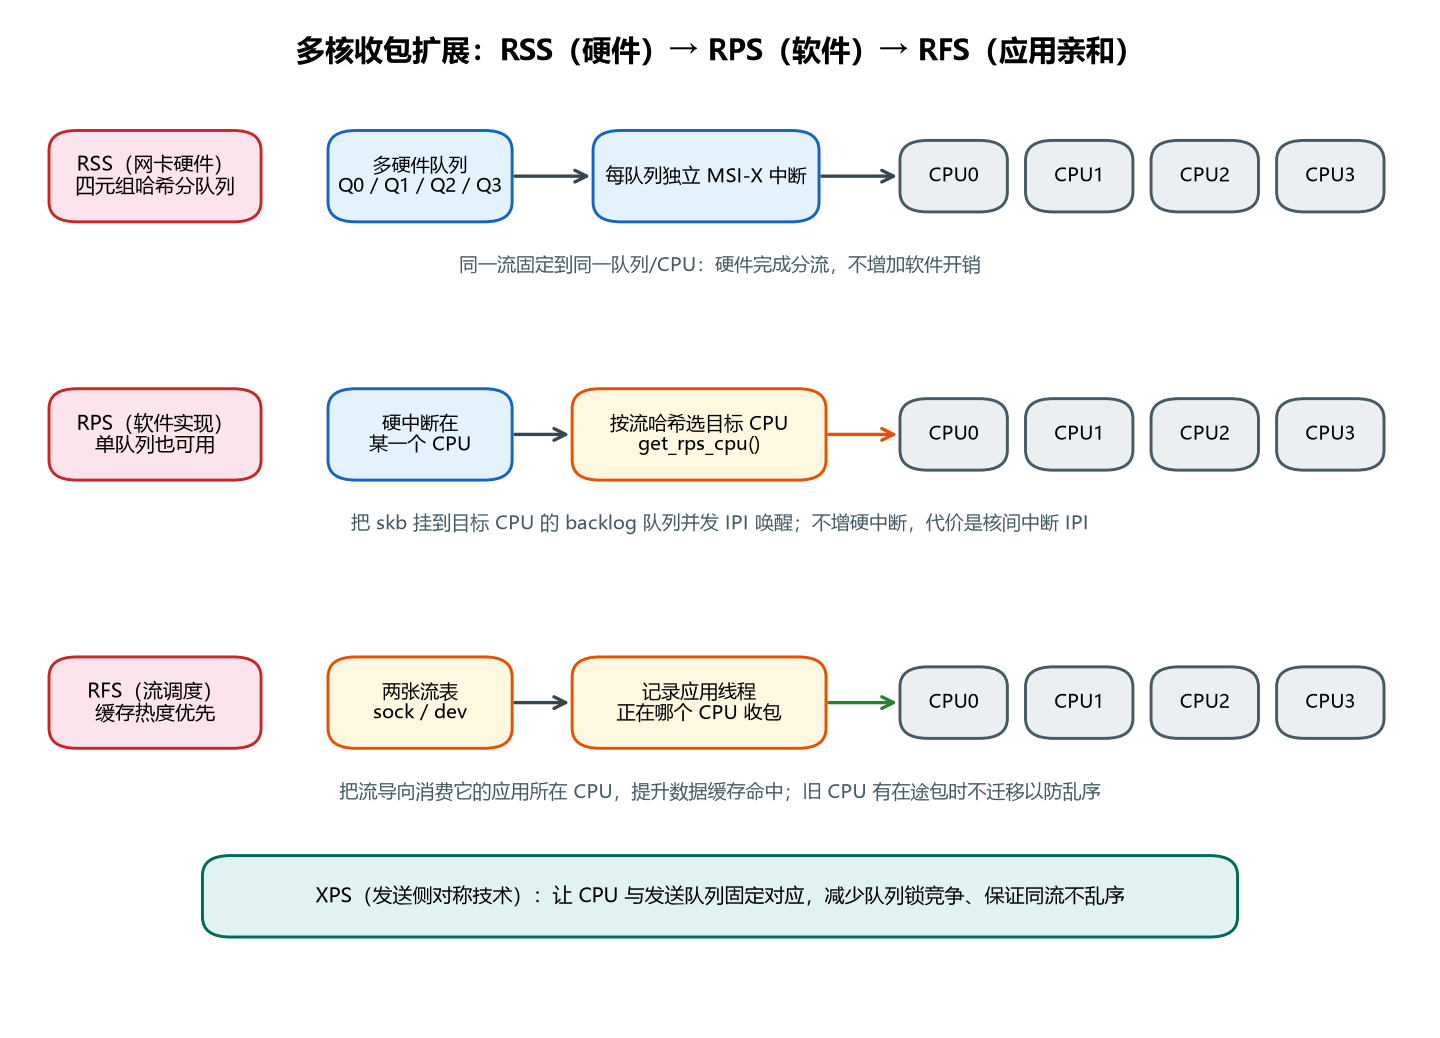
前面的收包路径默认在单个 CPU 上处理。万兆及以上网卡每秒收包数百万,单核很快成为瓶颈。内核提供一整套把网络负载摊到多个 CPU 的技术(见 Documentation/networking/scaling.rst),它们层层互补:
RSS(Receive Side Scaling,接收端扩展,硬件):多队列网卡对每个包按四元组(源/目的 IP、源/目的端口)算哈希(常用 Toeplitz 哈希),查一张间接分发表,把不同的流分到不同硬件接收队列;每个队列绑定独立的 MSI-X 中断,进而由不同 CPU 处理。同一条流总落到同一队列,既分摊了负载,又避免同一流的包在多个 CPU 间乱序。典型配置让队列数接近物理核数,可用
ethtool -l/-L查看修改,中断亲和性在/proc/irq/<n>/smp_affinity,irqbalance服务会动态调整。RPS(Receive Packet Steering,软件版 RSS):单队列网卡、或想在软件层再分摊时,在
netif_rx()/netif_receive_skb()里调用get_rps_cpu()按流哈希选一个目标 CPU,把 skb 挂到该 CPU 的 backlog 队列并发 IPI 唤醒它继续走协议栈。它对任何网卡都生效、不增加硬中断次数(代价是多了核间中断 IPI);目标 CPU 位图在/sys/class/net/<dev>/queues/rx-<n>/rps_cpus配置,默认 0 表示关闭。RFS(Receive Flow Steering,流调度):RPS 只按哈希分流,不管应用在哪个 CPU 收包,可能内核在 CPU0 处理、用户态却在 CPU7 读取,缓存不热。RFS 额外维护两张表:
rps_sock_flow_table记录每条流"期望的 CPU"(应用调用recvmsg/sendmsg时更新为运行该应用的 CPU),rps_dev_flow_table记录该流当前实际入队的 CPU;选 CPU 时向"期望 CPU"靠拢,并在旧 CPU 上确无在途包时才迁移,以免乱序。目标是让一条流的内核处理和用户态消费落在同一 CPU,提高数据缓存命中率。XPS(Transmit Packet Steering,发送侧):发送方向的对称技术,为每个发送队列配置可用的 CPU 集合(
xps_cpus/xps_rxqs),让在某 CPU 上运行的流优先走固定发送队列,减少队列锁竞争、利用缓存局部性;同一条流固定一个发送队列以防乱序,只有当流上没有在途包(skb->ooo_okay)时才允许换队列。
一句话区分:RSS 在硬件按流分队列,RPS 在软件按流分 CPU,RFS 进一步把流导向消费它的应用所在 CPU,XPS 在发送侧做同样的亲和安排。
6.5 发包路径(Transmit Path)
6.5.1 发包全景
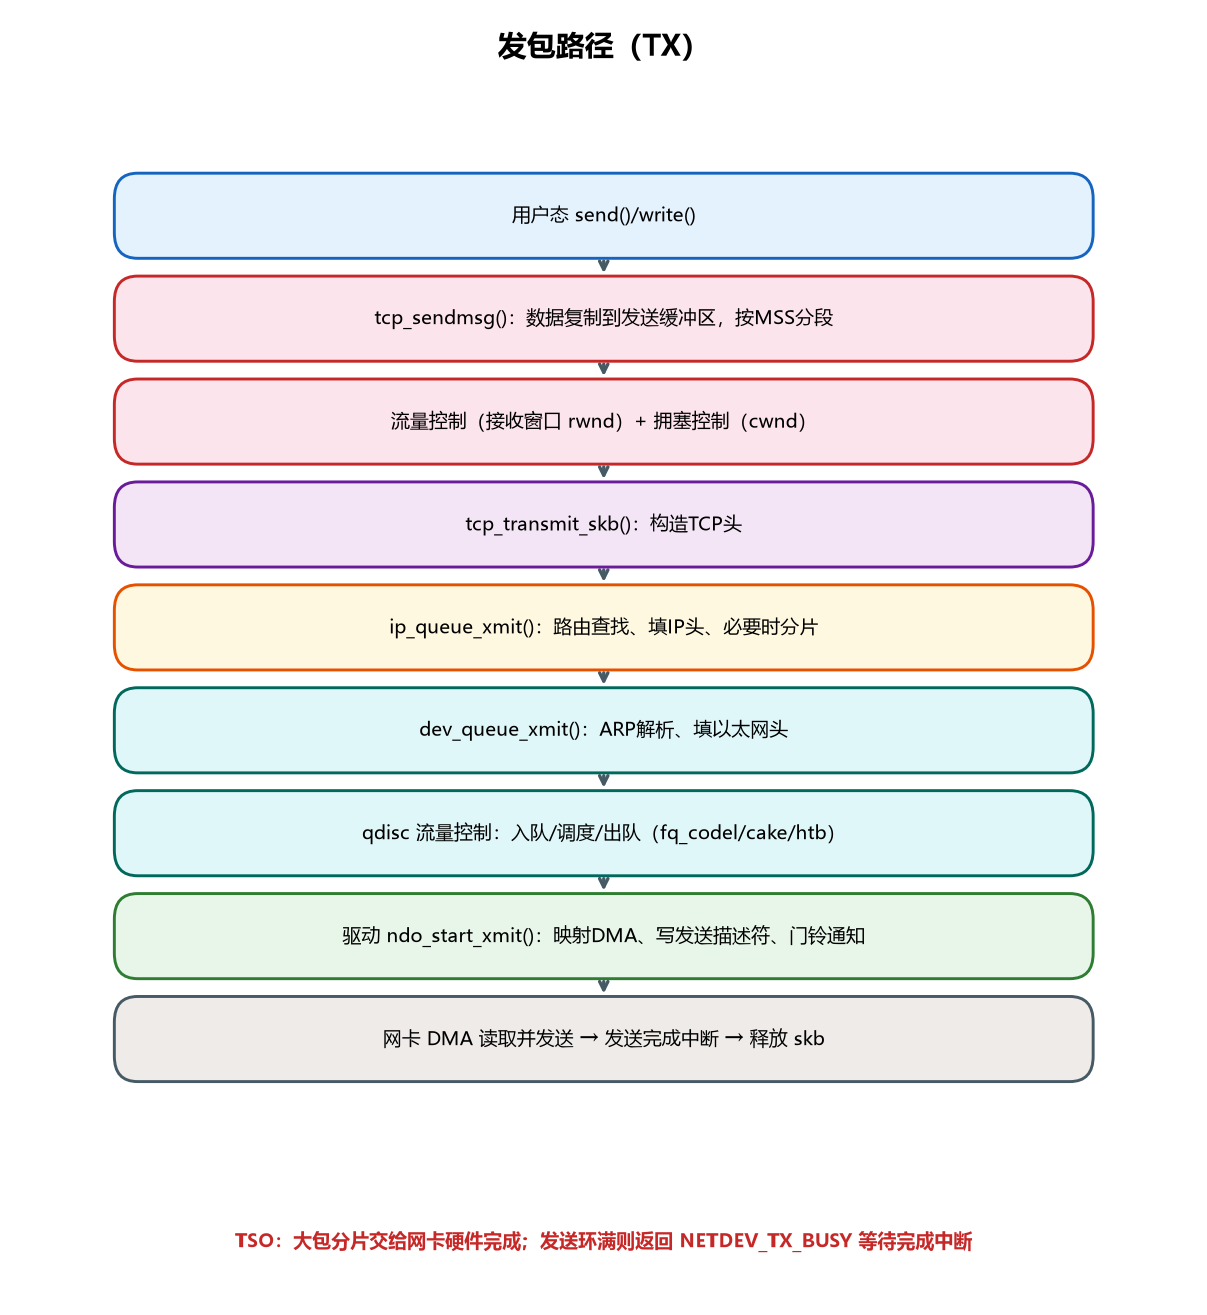
应用层 send()/write()
  │
  ▼
系统调用 → sock_sendmsg() → inet_sendmsg()
  │
  ▼
传输层
  TCP:tcp_sendmsg() → 复制数据到发送缓冲区(sk_write_queue)
       → tcp_write_xmit() → 拥塞控制、滑动窗口、分片
       → tcp_transmit_skb() → 构造 TCP 头
  UDP:udp_sendmsg() → 构造 UDP 头、路由查找、分片
  │
  ▼
网络层:ip_queue_xmit() / ip_send_skb()
  │  1. 路由查找(ip_route_output_flow)
  │  2. 填充 IP 头(源地址、目的地址、TTL、协议号、TOS)
  │  3. IP 分片(如果数据包大于 MTU,且不分片标志未设置)
  │
  ▼
链路层:dev_queue_xmit() → __dev_queue_xmit()
  │  1. 查找下一跳的 MAC 地址(ARP 表,neighbour 子系统)
  │  2. 填充以太网头(源 MAC、目的 MAC、协议类型)
  │  3. 进入流量控制(qdisc)队列
  │     - 有 qdisc(如 pfifo_fast/cake/fq_codel):入队、调度、出队
  │     - 无 qdisc(xmit_fast):直接发送
  │  4. 调用驱动的 ndo_start_xmit() 发送
  │
  ▼
网卡驱动
  │  1. 将 skb 放入网卡发送队列(Ring Buffer)
  │  2. 映射 DMA 地址(skb → 物理地址)
  │  3. 写入发送描述符(Tx Descriptor)
  │  4. 触发发送(写门铃寄存器)
  │
  ▼
网卡硬件
  │  DMA:从内存读取数据包数据
  │  发送到网络
  │  发送完成后触发中断(Tx Complete)
  │
  ▼
驱动发送完成中断
  │  1. 处理完成队列(Completion Queue)
  │  2. 释放 skb(kfree_skb)和 DMA 映射
  │  3. 唤醒等待发送完成的进程(如果发送队列满了)
6.5.2 TCP 发送:tcp_sendmsg()
TCP 发送的核心是发送缓冲区和流量控制/拥塞控制:
复制数据到发送缓冲区:
tcp_sendmsg()将用户态数据复制到内核发送缓冲区(sk_write_queue),每个 skb 代表一个 TCP 段(MSS 大小,通常 1460 字节)。流量控制:发送的数据量不能超过接收方的接收窗口(
rcv_wnd),否则接收方处理不过来。拥塞控制:发送的数据量不能超过拥塞窗口(
cwnd),否则网络会拥塞。已发送但未确认的数据量(in-flight)不能超过min(rcv_wnd, cwnd)。发送:
tcp_write_xmit()遍历发送缓冲区,发送满足窗口限制的段。重传:已发送的段在超时(RTO,Retransmission Timeout)或收到 3 个重复 ACK 后未确认,触发重传。
6.5.3 流量控制(qdisc)
**qdisc(queueing discipline,排队规则)**是 Linux 网络流量控制的核心,在链路层发送前对数据包进行排队、调度、限速、整形:
pfifo_fast:内核编译时的默认 qdisc(对应
CONFIG_DEFAULT_PFIFO_FAST),三个优先级队列(band 0/1/2),按 TOS 字段映射优先级,每个队列 FIFO,不支持限速。fq_codel:Fair Queue + Controlled Delay,公平队列加延迟控制。多数主流发行版通过
CONFIG_DEFAULT_FQ_CODEL或 sysctl 把它设为实际默认,用来缓解 bufferbloat(缓冲区膨胀导致的延迟)。cake:Common Applications Kept Enhanced,综合了公平队列、AQM、差分服务、限速的现代 qdisc,功能较全、配置相对简单。
htb:Hierarchical Token Bucket,层次化令牌桶,支持分层带宽分配和限速,常用于 QoS。
tbf:Token Bucket Filter,令牌桶过滤器,简单的单队列限速。
noqueue / xmit_fast:无队列,直接发送,用于虚拟设备或高性能场景。
qdisc 的核心是 enqueue()(入队)和 dequeue()(出队)函数,以及 restart()(重新启动发送)。发送时,__dev_queue_xmit() 调用 qdisc 的 enqueue() 将数据包入队,然后调用 qdisc_run() 从 qdisc 出队并调用驱动发送。
6.5.4 驱动发送与完成
网卡驱动的发送通常使用环形缓冲区(Ring Buffer):
发送描述符环(Tx Ring):存放待发送的数据包描述符(包含数据的 DMA 地址、长度、标志)。
驱动将 skb 的数据映射为 DMA 地址,写入描述符,更新写指针(tail)。
网卡硬件从描述符环读取描述符,DMA 读取数据,发送到网络。
发送完成后,网卡更新完成描述符(或完成队列 CQ),触发中断。
驱动中断处理程序处理完成描述符,释放 skb 和 DMA 映射,更新读指针(head)。
如果发送环满了(head == tail),驱动返回
NETDEV_TX_BUSY,协议栈停止发送,等待发送完成中断后重新启动。
现代网卡(如 10G/25G/100G)支持多队列(Multi-Queue):多个发送/接收队列,每个队列对应一个中断,可以绑定到不同 CPU,实现并行处理,避免单队列瓶颈。
6.6 TCP 协议
6.6.1 TCP 连接管理:三次握手与四次挥手
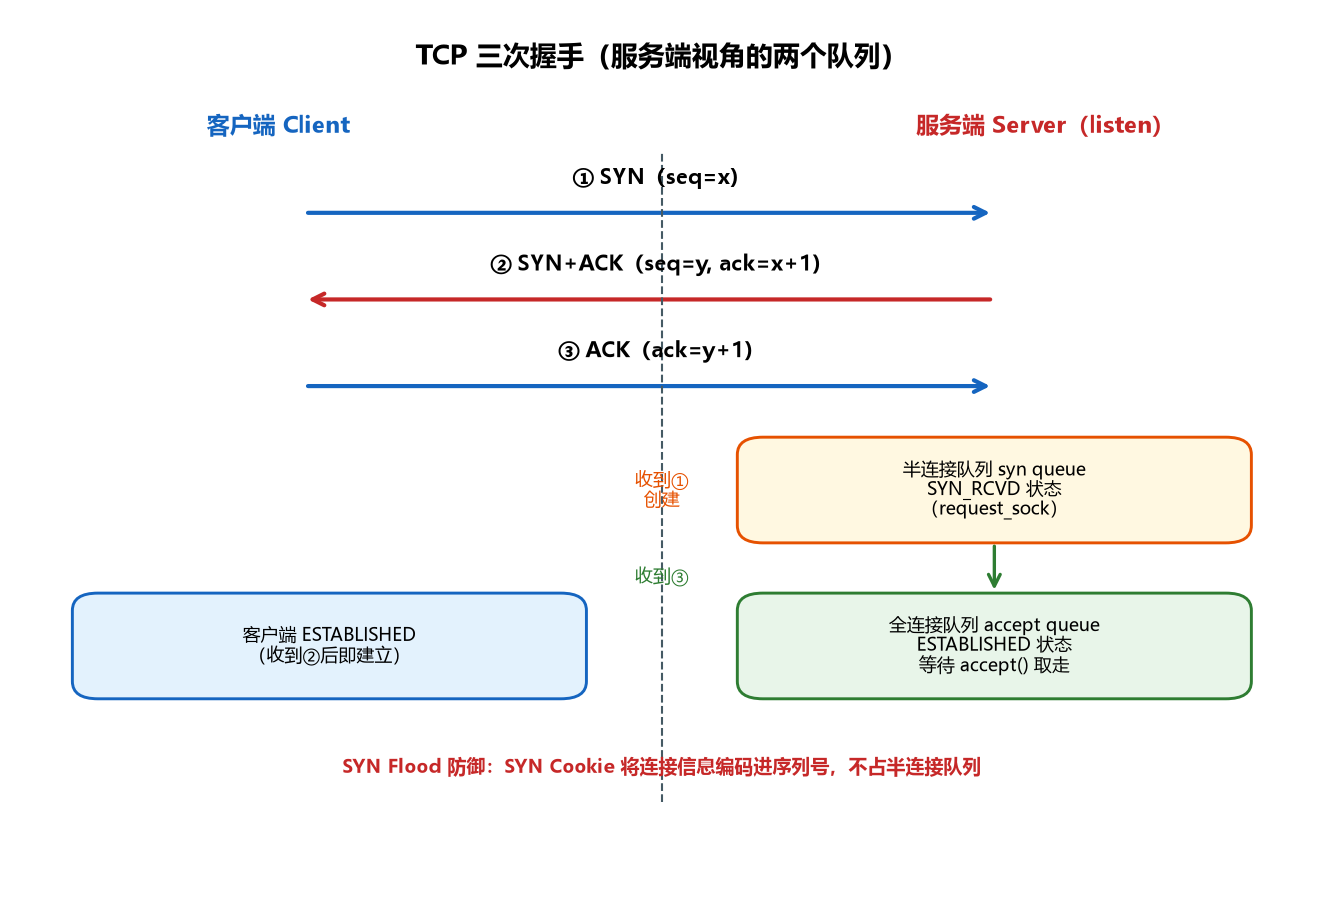
三次握手(Three-way Handshake):
客户端(C)                          服务端(S)
  │  LISTEN(监听)
  │
  │  SYN(seq=x)
  │ ───────────────────────────────→ │  收到 SYN
  │                                   │  分配 TCB,发送 SYN+ACK
  │  SYN+ACK(seq=y, ack=x+1)       │  状态:SYN_RCVD
  │ ←─────────────────────────────── │
  │  状态:ESTABLISHED
  │  ACK(ack=y+1)
  │ ───────────────────────────────→ │  收到 ACK
  │                                   │  状态:ESTABLISHED
内核实现:
服务端
listen()创建半连接队列(syn queue,存放 SYN_RCVD 状态的连接)和全连接队列(accept queue,存放 ESTABLISHED 状态等待 accept 的连接)。收到 SYN:
tcp_v4_conn_request()分配request_sock,加入半连接队列,发送 SYN+ACK。收到 ACK:
tcp_check_req()验证,创建完整的sock,从半连接队列移除,加入全连接队列,状态变为 ESTABLISHED。accept()从全连接队列取出连接,返回新的 socket。
SYN Flood 攻击与 SYN Cookie:
攻击者发送大量 SYN 包但不回应 ACK,半连接队列被占满,正常连接无法建立。
SYN Cookie 是一种防御机制:不分配
request_sock,而是将连接信息编码在 SYN+ACK 的序列号中,收到 ACK 时再重建连接。半连接队列不会被占满。
四次挥手(Four-way Handshake):
客户端(C)                          服务端(S)
  │  ESTABLISHED                      │  ESTABLISHED
  │  主动关闭
  │  FIN(seq=u)
  │ ───────────────────────────────→ │  收到 FIN
  │  状态:FIN_WAIT_1                 │  发送 ACK
  │  ACK(ack=u+1)                   │  状态:CLOSE_WAIT
  │ ←─────────────────────────────── │
  │  状态:FIN_WAIT_2                 │  等待应用层关闭
  │                                   │  应用层 close()
  │                                   │  FIN(seq=v)
  │ ←─────────────────────────────── │  状态:LAST_ACK
  │  收到 FIN
  │  ACK(ack=v+1)
  │ ───────────────────────────────→ │  收到 ACK
  │  状态:TIME_WAIT                  │  状态:CLOSED
  │  按实现定时器保持 TIME_WAIT
  │  状态:CLOSED
TIME_WAIT 状态的作用:
保证最后一个 ACK 能到达对端(如果丢失,对端会重传 FIN,TIME_WAIT 可以重发 ACK)。
给旧连接报文在网络中消散留出时间,降低它们与后续复用相同四元组的连接混淆的风险。协议分析常用 2MSL 解释这一目的。
Linux 5.15.220 将
TCP_TIMEWAIT_LEN定义为60*HZ,注释为约 60 秒。这是内核实现常量,不应反推成“Linux 的 MSL 默认 30 秒”。高并发服务端出现大量 TIME_WAIT 时,应先确认主动关闭方、连接复用方式与端口压力,再评估相关参数,不能只靠调整tcp_tw_reuse。
6.6.2 TCP 可靠传输:序列号与确认
TCP 通过序列号(Sequence Number)和确认号(Acknowledgment Number)实现可靠传输:
每个字节的数据都有一个序列号。
SYN 和 FIN 也占用一个序列号。
确认号表示期望收到的下一个字节的序列号,即确认号之前的所有字节都已正确收到。
累计确认(Cumulative Acknowledgment):ACK 确认的是连续的已接收数据,乱序数据不会被确认(直到缺失的数据到达)。
选择确认(SACK,Selective Acknowledgment):可以告知发送方哪些不连续的数据段已收到,帮助发送方只重传缺失的段,提高效率。
6.6.3 TCP 流量控制:滑动窗口
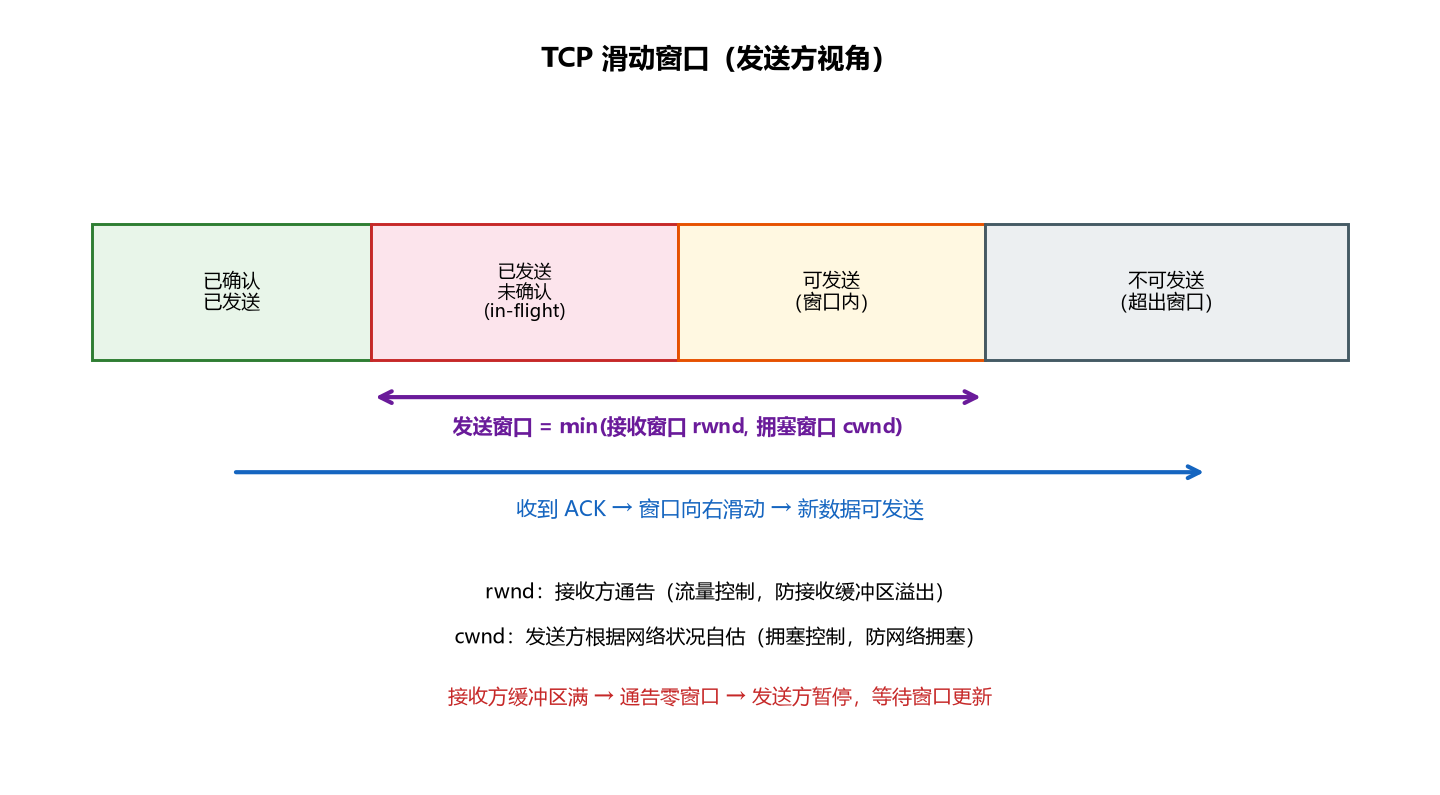
**滑动窗口(Sliding Window)**是 TCP 流量控制的核心机制:
接收方在 ACK 中告知发送方自己的接收窗口大小(
rcv_wnd,即接收缓冲区的剩余空间)。发送方已发送但未确认的数据量不能超过接收窗口,否则接收方缓冲区溢出。
发送方的发送缓冲区分为:已确认已发送、已发送未确认(in-flight)、未发送可发送、未发送不可发送(超出窗口)。
随着 ACK 的到达,窗口向右滑动,新的数据可以发送。
零窗口(Zero Window):如果接收方缓冲区满了,发送窗口为 0,发送方停止发送。接收方定期发送窗口更新(Window Update)告知新的窗口大小,发送方恢复发送。
6.6.4 TCP 拥塞控制
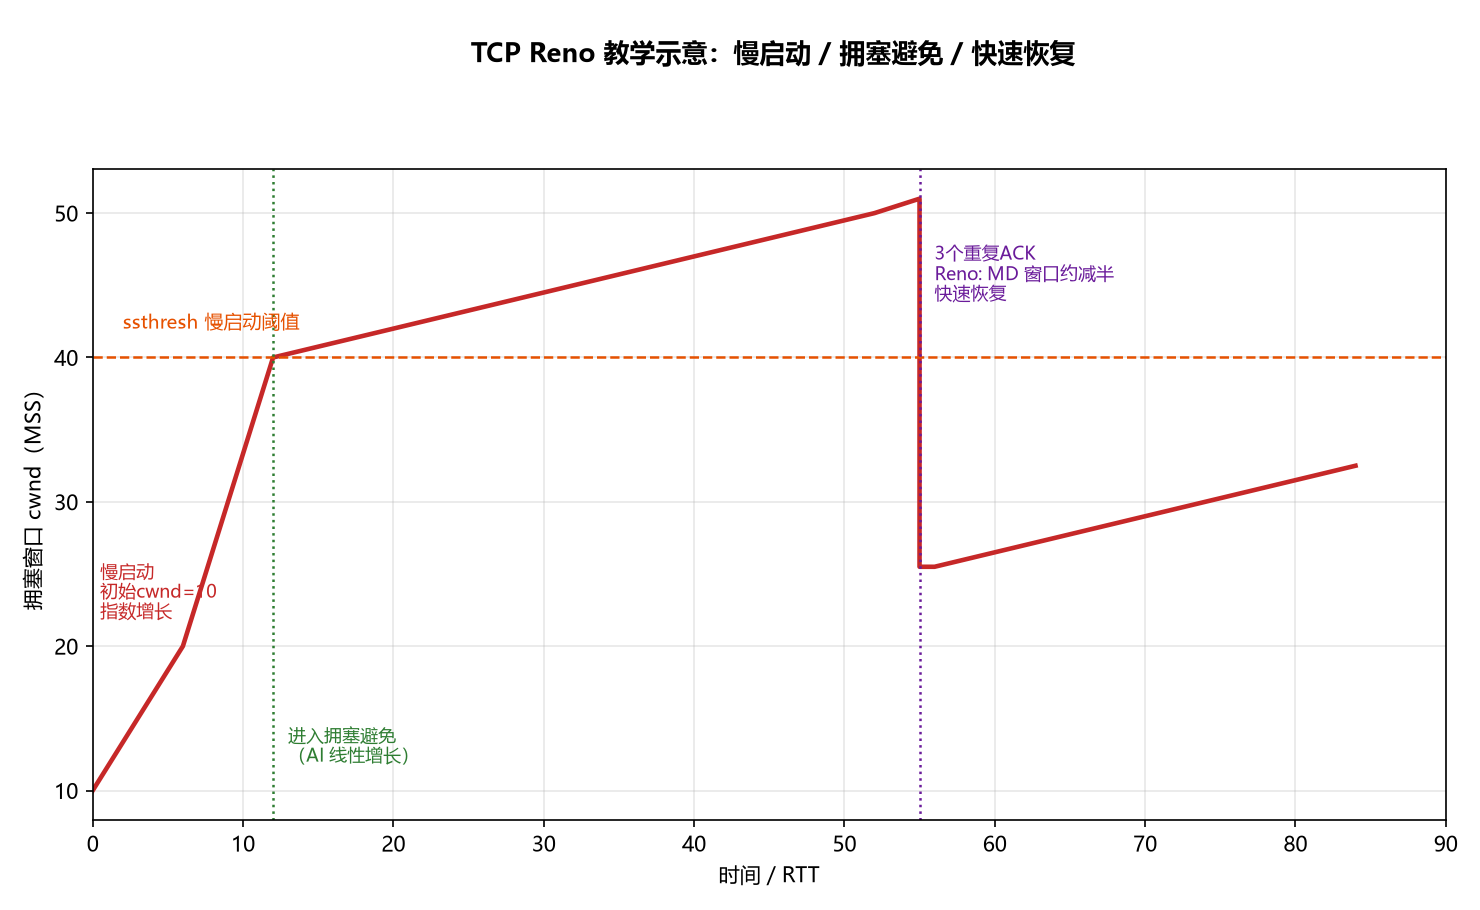
**拥塞控制(Congestion Control)**是 TCP 最复杂的部分,目标是在网络拥塞时降低发送速率,避免网络崩溃,同时在网络空闲时提高发送速率,充分利用带宽。
四个核心算法:
慢启动(Slow Start):
连接建立时,拥塞窗口
cwnd从初始窗口TCP_INIT_CWND = 10个 MSS 开始(5.15 的取值,早期内核曾为 1)。每收到一个 ACK,
cwnd增加 1 个 MSS → 每个 RTT(往返时间)cwnd翻倍(指数增长)。直到达到慢启动阈值
ssthresh,进入拥塞避免。“慢启动"其实增长很快(指数),只是相对于一开始就用满带宽来说是"慢"的。
拥塞避免(Congestion Avoidance):
cwnd超过ssthresh后,每个 RTT 增加 1 个 MSS(线性增长,加法增大 AI)。缓慢探测可用带宽,避免突然发送过多导致拥塞。
快速重传(Fast Retransmit):
收到 3 个重复 ACK(DupACK)时,说明某个段丢失了(接收方收到了后续的段但缺了中间的)。
不等超时(RTO,可能很长),立即重传缺失的段。
大大减少了丢包后的重传延迟。
快速恢复(Fast Recovery,以 Reno 语义说明):
快速重传后不把
cwnd降到 1,而是按拥塞控制算法计算新的ssthresh,利用重复 ACK 维持管道,并在恢复结束后进入拥塞避免。Reno 的乘法减小通常可近似理解为减半。收到 3 个重复 ACK 表明仍有报文和 ACK 在流动,因此不必像超时那样从最小窗口重新慢启动。
AIMD(Additive Increase Multiplicative Decrease,加法增大乘法减小):
拥塞避免阶段:每个 RTT 加 1(AI)。
对 Reno 而言,检测到拥塞后的乘法减小通常近似为窗口减半;其他算法使用自己的回退系数。
AIMD 是 TCP 公平性的基础:多个流共享带宽时,通过 AI/MD 最终收敛到公平分配。
Linux 支持的拥塞控制算法:
CUBIC:Linux 5.15 的常用默认算法,窗口增长由三次函数主导。该版本
tcp_cubic.c的默认beta为717/1024,拥塞后的目标窗口约为原窗口的 70%,不是简单减半;算法还包含 fast convergence、TCP friendliness 和 HyStart 等逻辑。Reno:传统算法,标准 AIMD + 快速恢复。
BIC:CUBIC 的前身,二分搜索增长。
BBR(Bottleneck Bandwidth and RTT):Google 开发的现代拥塞控制算法,不基于丢包信号,而是基于测量的瓶颈带宽和 RTT 来控制发送速率,在有丢包的网络(如无线网络)中性能更好,但公平性与传统基于丢包的算法有争议。
Westwood+:基于带宽估计的算法,适合无线网络。
可以通过
/proc/sys/net/ipv4/tcp_congestion_control设置默认算法,通过setsockopt(TCP_CONGESTION)为单个连接设置。
6.6.5 TCP 缓冲区与内存
每个 TCP socket 有两个缓冲区:
发送缓冲区(
sk_wmem_alloc):存放已发送未确认和待发送的数据。大小由SO_SNDBUF设置(或自动调整,tcp_wmem三个值:min/default/max)。接收缓冲区(
sk_rmem_alloc):存放已接收未被应用读取的数据。大小由SO_RCVBUF设置(或自动调整,tcp_rmem)。
自动调整(Auto-tuning):Linux 默认启用 TCP 缓冲区自动调整(tcp_moderate_rcvbuf),根据连接的实际带宽和 RTT 动态调整接收缓冲区大小,目标是缓冲区大小 = 带宽 × RTT(BDP,Bandwidth-Delay Product),以充分利用带宽。
TCP 内存限制:
tcp_mem:三个值(low/pressure/high),单位是页,控制系统范围内 TCP 内存使用的阈值。低于 low:TCP 内存不受限制。
高于 pressure:开始调节(减少发送缓冲区、抑制新分配)。
高于 high:拒绝新的 TCP 内存分配。
6.7 网络子系统总结
收包:
  网卡中断 → 驱动取包 → NAPI 软中断批量处理(budget+时间限制)
  → GRO 合并小包 → eth_type_trans() 链路层
  → ip_rcv() 网络层(路由判断:本机/转发)
  → tcp_v4_rcv()/udp_rcv() 传输层(查找 socket、放入接收队列)
  → recv() 复制到用户态

发包:
  send() → TCP/UDP 层构造报文(拥塞控制/流量控制/分片)
  → ip_queue_xmit() 网络层(路由+IP头+分片)
  → dev_queue_xmit() 链路层(MAC头+qdisc流量控制)
  → 驱动 ndo_start_xmit() → 网卡 DMA 发送
  → 发送完成中断 → 释放 skb

核心机制:
  sk_buff:贯穿全栈的数据包表示,协议头 push/pull 零拷贝操作
  NAPI:中断+轮询,高流量下减少中断风暴
  GRO/TSO:收包合并/发包分片,减少协议栈处理开销
  TCP:三次握手/四次挥手、滑动窗口流量控制、AIMD拥塞控制、可靠重传
  qdisc:流量控制与排队(fq_codel/cake/htb)
  多队列:多发送/接收队列并行处理,适配多核 CPU
本章要点:
分层协议栈:链路层/网络层/传输层各司其职,通过 skb 传递,每层 push/pull 协议头,零拷贝。
中断 + 轮询(NAPI):低流量中断响应快,高流量轮询吞吐高,兼顾响应性和吞吐量。
批处理与合并:NAPI 批量取包、GRO 合并小包、TSO 大包分片,减少 per-packet 开销。
每 CPU 数据结构:
softnet_data、backlog、NAPI 列表每 CPU 独立,避免全局锁。Socket 缓冲区:发送/接收缓冲区解耦应用与协议栈,应用读写与协议栈收发异步进行。
TCP 复杂机制:连接管理(三次握手/四次挥手)、可靠传输(序列号/确认/重传)、流量控制(滑动窗口)、拥塞控制(AIMD/CUBIC/BBR),在不可靠的 IP 之上提供可靠的字节流服务。
DISCUSSION
评论